Nachdem die AMD-Grafikkarte in der KI-VM auf Knoten 3 durchgereicht war (siehe Lokale KI mit AMD-GPU unter Proxmox), stand die Auswahl der passenden Modelle für das automatische Datenaufräumen an. Öffentliche Bestenlisten helfen mir wenig, wenn ein Modell deutsche Rechnungen zerlegen, Downloads einsortieren und Handyfotos nach Kategorien trennen soll. Deshalb habe ich einen eigenen Testkatalog mit frei lizenzierten und erfundenen Testdaten gebaut und 26 Modelle durch eine Vorrunde sowie zusätzliche Speichertests geschickt. Alle Messwerte gelten nur für diese Hardware mit 16 GB VRAM (Leistungsgrenze 239 Watt) und meinen konkreten Testsatz.
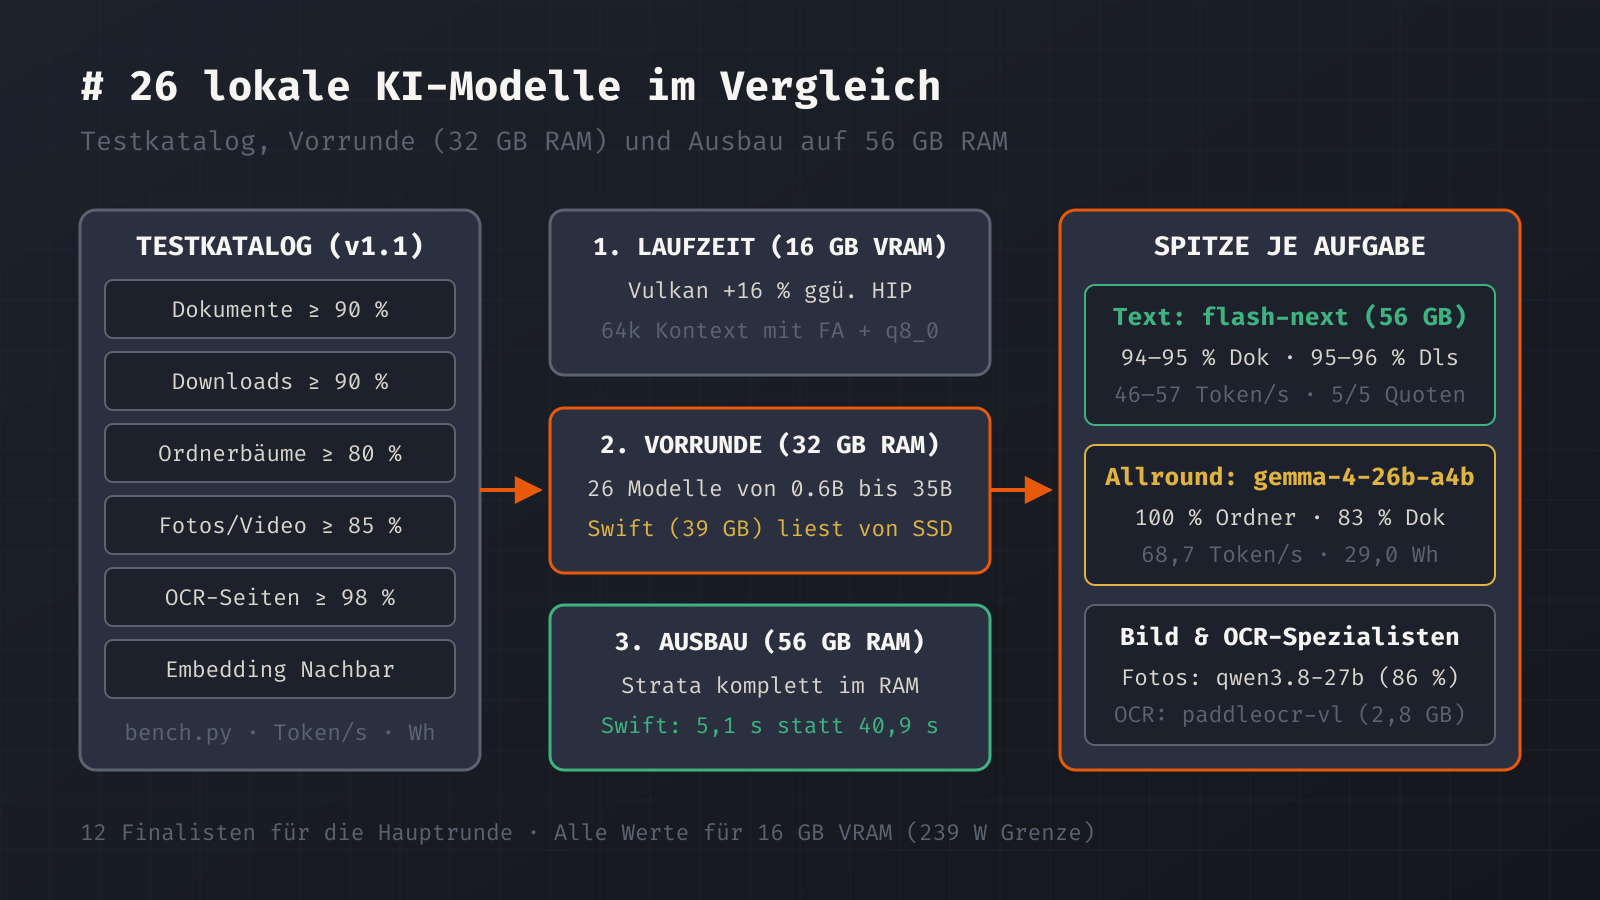
Was der Testkatalog abfragt und wie bench.py misst
Das Testskript bench.py prüft sieben Aufgaben aus dem Alltag meiner Dateiablage. Alle Dateien im Testsatz v1 (Ordnerbäume in Version v1.1) sind frei lizenziert oder künstlich erzeugt, damit keine privaten Briefe oder Fotos in den Läufen landen. Geplant ist, den Vergleich alle zwei Monate mit neuen Modellen zu wiederholen.
- Bei Dokumenten müssen die Modelle fünf Felder im JSON-Format aus Briefen und Belegen lesen: Absender, Dokumentart, Datum, Betrag und Zielordner. Zusätzlich protokolliert das Skript, ob die Ausgabe gültiges JSON ist, ob ein zweiter Aufruf exakt dieselbe Antwort liefert und wie viele Sekunden ein Dokument dauert. Die vorgeschlagene Mindestquote liegt bei 90 Prozent über alle Felder, mindestens 95 Prozent beim Betrag und höchstens 10 Sekunden Rechenzeit pro Dokument.
- Für Downloads ordnen die Modelle Archive und Installationspakete einer Kategorie und einem Zielordner zu (Vorschlag für die Mindestquote: 90 Prozent).
- Bei Ordnerbäumen sollen vorhandene Verzeichnisse bewertet und Zielpfade vorgeschlagen werden (Mindestquote: 80 Prozent).
- Der Fototest umfasst 36 Bilder aus neun Kategorien mit je vier Beispielen: Dokument/Beleg, Essen, Fehlauslösung, Landschaft/Urlaub, Meme/Weiterleitung, Personen, Produkt/Notiz, Screenshot und Tiere. Dazu kommen kurze Videoclips (Mindestquote 85 Prozent) sowie das Lesen von Text im Bild.
- Die Texterkennung (OCR) misst auf gerenderten Seiten inklusive Tabelle und Kassenbon den Wert
1 − Zeichenfehlerquotebei einer Zielmarke von 98 Prozent. - Beim Embedding-Test zählt der Anteil der Fälle, in denen der nächste Nachbar im Vektorraum dieselbe Dokumentart trägt.
Neben den Trefferquoten zeichnet bench.py für jedes Modell das Ausgabetempo in Token pro Sekunde, die Ladezeit in Sekunden, den belegten Videospeicher (VRAM), die durchschnittliche und maximale Leistungsaufnahme der GPU in Watt sowie die gesamte elektrische Arbeit des Laufs in Wattstunden (Wh) auf.
Zwei Fehler im eigenen Testaufbau
Während die Vorrunde am Abend des 22. Oktober lief, fielen zunächst alle Bildmodelle beim Fototest durch: Kein einziges kam über 30 Prozent. Die Ursache lag in meinem eigenen Prompt und dem JSON-Schema. Das Schema verlangte als erstes Feld die Kategorie, und der System-Prompt endete mit der Definition von „Fehlauslösung“. Kleine Modelle übernahmen diesen letzten Begriff fast blind für jedes Bild. Um 23:30 Uhr habe ich das Schema umgestellt: Erst muss das Modell eine kurze Bildbeschreibung ausgeben, danach folgt die Kategorie, und im Prompt sind alle neun Kategorien gleichwertig erklärt. Bei der Nachmessung der fünf bis dahin fertigen Bildmodelle sprang mimo-v2.6-9b bei Fotos von 11 auf 72 Prozent (und bei Videos auf 100 Prozent), minicpm-v-4.6 stieg von 25 auf 53 Prozent.
Ein zweiter Fehler steckte im Test für Ordnerbäume. In der ersten Fassung v1 lagen selbst die besten Modelle (qwen3.8-27b und gemma-4-26b-a4b) dicht gedrängt bei 74 bis 75 Prozent. Bei der Kontrolle der 61 Testfälle am nächsten Morgen stellte sich heraus, dass 16 Fälle kaum lösbar waren: Die Musterlösung verlangte Zielordner wie Fotos/<Jahr>, obwohl im Verzeichnisbaum gar kein Datum vorkam, und der Zielordner „Löschen-prüfen“ war in der Anweisung nicht erklärt. Nach der Korrektur auf v1.1 habe ich die Ordner-Aufgabe für alle Modelle nachgemessen. Damit trennt der Test sauber: gemma-4-26b-a4b erreicht 100 Prozent, flash-next-gyro-s 98 Prozent sowie qwen3.8-27b, bonsai-2-27b und muse-glimmer-30b jeweils 95 Prozent.
HIP gegen Vulkan: Laufzeit-Smoketest auf der AMD-GPU
Vor dem Start der Vorrunde habe ich am 22. Oktober geprüft, mit welchem Backend die Karte unter llama.cpp effizienter arbeitet. Die KI-VM lief bereits mit Bindung an die Leistungskerne des Prozessors, aktivierten Hugepages und 4 MB Vorauslese. Als Testlast diente Qwen3.8-27B in der Quantisierung UD-Q3_K_XL mit einem Prompt von 5.866 Token (zwölf Testbriefe), 256 Token Antwort bei Temperatur 0 und einer GPU-Leistungsgrenze von 239 Watt.
| Variante | Kontext | Optionen | VRAM | Einlesen (Token/s) | Antwort (Token/s) | GPU Ø | Wh je 1.000 Token |
|---|---|---|---|---|---|---|---|
| Produktiv-Build (PrismML 25.09., HIP) | 8k | FA aus | 14,1 GB | 428 | 22,4 | 234 W | 6,4 |
| llama.cpp 22.10., HIP | 8k | FA aus | 14,2 GB | 472 | 23,6 | 234 W | 5,9 |
| llama.cpp 22.10., Vulkan | 8k | FA aus | 13,9 GB | 423 | 25,9 | 230 W | 5,9 |
| llama.cpp 22.10., Vulkan | 8k | FA an | 13,4 GB | 246 | 16,7 | 211 W | 9,0 |
| llama.cpp 22.10., Vulkan | 64k | FA an, KV q8_0 | 15,0 GB | 240 | 14,9 | 202 W | 9,1 |
| llama.cpp 22.10., HIP | 64k | FA aus, K q8_0 | – | – | – | – | startet nicht (3,3 GB Puffer fehlen) |
Das aktuelle llama.cpp-Build vom 22. Oktober ist unter HIP bereits 5 bis 10 Prozent schneller als mein älterer Produktiv-Build vom September. Vulkan ohne Flash Attention liefert mit 25,9 Token/s die schnellsten Antworten (+16 Prozent gegenüber dem alten Build), liest den Prompt mit 423 statt 472 Token/s aber etwas langsamer ein als HIP.
Schaltet man Flash Attention unter Vulkan ein, sinkt das Tempo um 35 bis 40 Prozent auf 16,7 Token/s, und der Stromverbrauch pro 1.000 Antwort-Token steigt von 5,9 auf 9,0 Wh. Dafür ist Vulkan mit Flash Attention und q8_0-Quantisierung für den KV-Cache die einzige Kombination, mit der das 27B-Modell bei 64k Kontext in 15,0 GB VRAM passt. Unter HIP bricht der Start mit 64k Kontext ab, weil 3,3 GB Rechenpuffer nicht mehr in den Videospeicher passen. Für Dienste mit einem 38k-Token-Systemprompt ist Vulkan mit Flash Attention auf dieser Karte gesetzt; für das Datenaufräumen mit kurzen Kontexten bis 8k oder 16k habe ich ab gemma-4-e4b Vulkan ohne Flash Attention verwendet.
Vorrunde: 26 Modelle mit 32 GB RAM im Vergleich
In der Nacht vom 22. auf den 23. Oktober liefen 26 Modelle auf der KI-VM mit 32 GB Arbeitsspeicher durch den kleinen Testsatz. Die folgende Tabelle zeigt den Stand nach den Nachmessungen für Fotos und Ordner (v1.1).
| Modell | Dokumente | Downloads | Ordner (v1.1) | Fotos | Videos | OCR | Token/s | VRAM | Energie | Laufzeit / Hinweis |
|---|---|---|---|---|---|---|---|---|---|---|
| flash-next-swift-iq2xs | 94 % | 48 % | 64 % | – | – | – | 23,5 | 16,6 GB | 32,4 Wh | Strata (40,9 s/Dok) |
| gemma-4-12b | 87 % | 80 % | 92 % | 81 % | 88 % | 100 % | 33,4 | 11,0 GB | 37,6 Wh | llama.cpp Vulkan |
| flash-next-gyro-s | 86 % | 97 % | 98 % | – | – | – | 45,7 | 16,6 GB | 13,6 Wh | Strata |
| qwen3.8-27b | 85 % | 60 % | 95 % | 86 % | 75 % | 100 % | 26,3 | 15,9 GB | 48,0 Wh | llama.cpp Vulkan |
| bonsai-2-27b | 84 % | 66 % | 95 % | – | – | – | 36,9 | 7,1 GB | 20,9 Wh | PrismML HIP |
| qwen3.6-35b-a3b | 84 % | 78 % | 72 % | 83 % | 88 % | 100 % | 43,1 | 16,0 GB | 15,9 Wh | llama.cpp Vulkan (Ordner v1) |
| gemma-4-26b-a4b | 83 % | 82 % | 100 % | 81 % | 88 % | 100 % | 68,7 | 16,0 GB | 29,0 Wh | llama.cpp Vulkan |
| gemma-4-e4b | 83 % | 78 % | – | 11 % | 0 % | – | 71,9 | 4,5 GB | 18,8 Wh | llama.cpp Vulkan |
| mimo-v2.6-9b | 83 % | 52 % | 75 % | 72 % | 100 % | 100 % | 50,2 | 7,8 GB | 24,8 Wh | llama.cpp Vulkan |
| granite-4.2-30b | 82 % | 71 % | 57 % | – | – | – | 24,2 | 16,7 GB | 38,4 Wh | llama.cpp Vulkan (Ordner v1) |
| muse-glimmer-30b | 81 % | 90 % | 95 % | 83 % | 75 % | 100 % | 27,5 | 16,0 GB | 119,6 Wh | llama.cpp Vulkan |
| qwen3-vl-8b | 81 % | 76 % | 82 % | 86 % | 88 % | 100 % | 41,4 | 12,9 GB | 28,4 Wh | llama.cpp Vulkan |
| minicpm-v-4.7-35b-a3b | 80 % | 76 % | 70 % | 78 % | 88 % | 100 % | 58,5 | 16,0 GB | 13,1 Wh | llama.cpp Vulkan (Ordner v1) |
| apertus-v1.5-8b | 79 % | 50 % | 69 % | – | – | – | 42,1 | 9,7 GB | 14,6 Wh | llama.cpp Vulkan |
| gpt-oss-20b | 70 % | 82 % | 85 % | – | – | – | 108,8 | 12,5 GB | 6,4 Wh | llama.cpp Vulkan |
| minicpm5-2b | 70 % | 22 % | – | – | – | – | 108,5 | 2,3 GB | 3,7 Wh | PrismML HIP |
| bonsai-2-9b | 69 % | 49 % | – | 83 % | 62 % | – | 89,8 | 8,7 GB | 9,7 Wh | PrismML HIP |
| minicpm-v-4.7-1b | 38 % | – | – | 44 % | 38 % | – | 109,5 | 2,0 GB | 5,3 Wh | PrismML HIP |
| minicpm-v-4.6 | 35 % | – | – | 53 % | 50 % | 100 % | 93,0 | 1,8 GB | 6,7 Wh | llama.cpp Vulkan |
| dots.ocr | – | – | – | – | – | 100 % | – | 4,2 GB | 3,1 Wh | llama.cpp Vulkan (9,9 s/Seite) |
| olmocr-2-7b | – | – | – | – | – | 100 % | – | 7,8 GB | 2,2 Wh | llama.cpp Vulkan |
| paddleocr-vl-1.6 | – | – | – | – | – | 100 % | – | 2,8 GB | 1,0 Wh | llama.cpp Vulkan (3,7 s/Seite) |
| deepseek-ocr-2 | – | – | – | – | – | 99 % | – | 5,9 GB | 0,7 Wh | llama.cpp Vulkan |
| lightonocr-3-4b | – | – | – | – | – | 98 % | – | 6,3 GB | 1,7 Wh | llama.cpp Vulkan |
| qwen3-embedding-4b | – | – | – | – | – | – | – | 4,6 GB | 0,9 Wh | HIP; Nachbar: 76 % |
| qwen3-embedding-0.6b | – | – | – | – | – | – | – | 2,1 GB | 0,2 Wh | HIP; Nachbar: 58 % |
Kleine Modelle von 1B bis 4B reichen für das Sortieren von Dokumenten nicht aus. Einzige Ausnahme beim Text ist gemma-4-e4b: Es trifft bei Dokumenten 83 Prozent (Zielordner 95 Prozent) und läuft mit 71,9 Token/s in 4,5 GB VRAM, versagt aber bei Fotos mit 11 Prozent. Bei 31 von 36 Bildern lieferte es ungültiges JSON, weil es endlose Leerzeilen unter das Schema schrieb.
Blickt man in die Einzelfelder der Dokumenten-Aufgabe, zeigen fast alle Modelle von 8B bis 35B dasselbe Muster: Absender und Datum sitzen zu 100 Prozent, der Zielordner zu 90 bis 100 Prozent, aber der Betrag landet fast durchweg bei 50 bis 55 Prozent. Die Modelle scheitern regelmäßig an negativen Beträgen bei Gutschriften und Erstattungen. Auch die Dokumentart erreicht meist nur 60 bis 70 Prozent. Nur die beiden Strata-Varianten von Qwen3.8-Flash-Next kommen beim Betrag auf 85 beziehungsweise 95 Prozent.
Beim Stromverbrauch und Tempo setzen sich die Mixture-of-Experts-Modelle (MoE) deutlich von dichten Modellen ab: gemma-4-26b-a4b (68,7 Token/s, 29,0 Wh), minicpm-v-4.7-35b-a3b (58,5 Token/s, 13,1 Wh, in v1.1 später 97 % bei Ordnern) und qwen3.6-35b-a3b (43,1 Token/s, 15,9 Wh) erledigen alle Aufgaben mit einem Bruchteil der Energie, die dichte 27B- bis 30B-Modelle wie qwen3.8-27b (48,0 Wh) oder granite-4.2-30b (38,4 Wh) benötigen.
Einen Sonderfall bildete muse-glimmer-30b. Im ersten Durchlauf gab das Modell ausschließlich leere Antworten zurück. Es denkt vor jeder Antwort intern nach; weder enable_thinking noch --reasoning-budget 0 schalteten das ab, sodass der Denktext das Ausgabelimit komplett verbrauchte. Erst mit reasoning_strength: none und mindestens 1.024 Token Ausgabelimit kamen verwertbare Antworten zustande (81 Prozent Dokumente, 90 Prozent Downloads, 95 Prozent Ordner in v1.1), allerdings bei 119,6 Wh – dem höchsten Energieverbrauch im gesamten Testfeld.
Bei den Fotos teilen sich qwen3.8-27b und qwen3-vl-8b mit je 86 Prozent den ersten Platz. Die meisten Fehlgriffe passieren in der Kategorie „Produkt/Notiz“ (oft nur 1 von 4 Bildern richtig) und bei „Fehlauslösung“, während qwen3.8-27b Text im Bild zu 97 Prozent erkennt (gemma-4-12b kommt dort nur auf 61 Prozent). Die spezialisierten OCR-Modelle lesen die sauberen Testseiten fast ohne Fehler; paddleocr-vl-1.6 benötigt dafür nur 2,8 GB VRAM, 3,7 Sekunden pro Seite und 1,0 Wh für den gesamten Durchlauf.
Was Arbeitsspeicher ausmacht: von 16 über 32 auf 56 GB RAM
Wie stark der Arbeitsspeicher der VM das Tempo begrenzt, zeigte sich zuerst bei Qwen3.8-Flash-Next (125B MoE), das über die Laufzeitumgebung Strata teilweise im VRAM (16,6 GB) und teilweise im System-RAM läuft. Am Nachmittag des 22. Oktober erreichte die kleinste Stufe flash-next-gyro-s auf der VM mit 16 GB RAM lediglich 22,8 Token/s. Nach dem Ausbau auf 32 GB RAM, aktivierten Hugepages und Kernbindung verdoppelte sich das Tempo in der Vorrunde auf 45,7 Token/s (im Vorabtest 47 Token/s). Eine Schwäche von Strata im Vergleich zu llama-server blieb: Strata prüft das JSON-Schema nur nachträglich statt es während der Ausgabe zu erzwingen; bei 2 von 20 Dokumenten lieferte gyro-s in der Vorrunde ungültiges JSON (Antwortcode 502).
Für die nächstgrößere Stufe flash-next-swift-iq2xs (39 GB Modellgröße, Strata empfiehlt 46 GB RAM) reichten 32 GB Arbeitsspeicher nicht mehr. Das Modell lieferte in der Vorrunde zwar 94 Prozent bei Dokumenten, brauchte aber 40,9 Sekunden pro Dokument und kam bei Downloads nur auf 48 Prozent, weil jede zweite lange Antwort das JSON-Format verfehlte. Da die Gewichte nicht vollständig in VRAM und RAM passten, las Strata während jeder Anfrage dauerhaft mit rund 500 MB/s von der SSD nach.
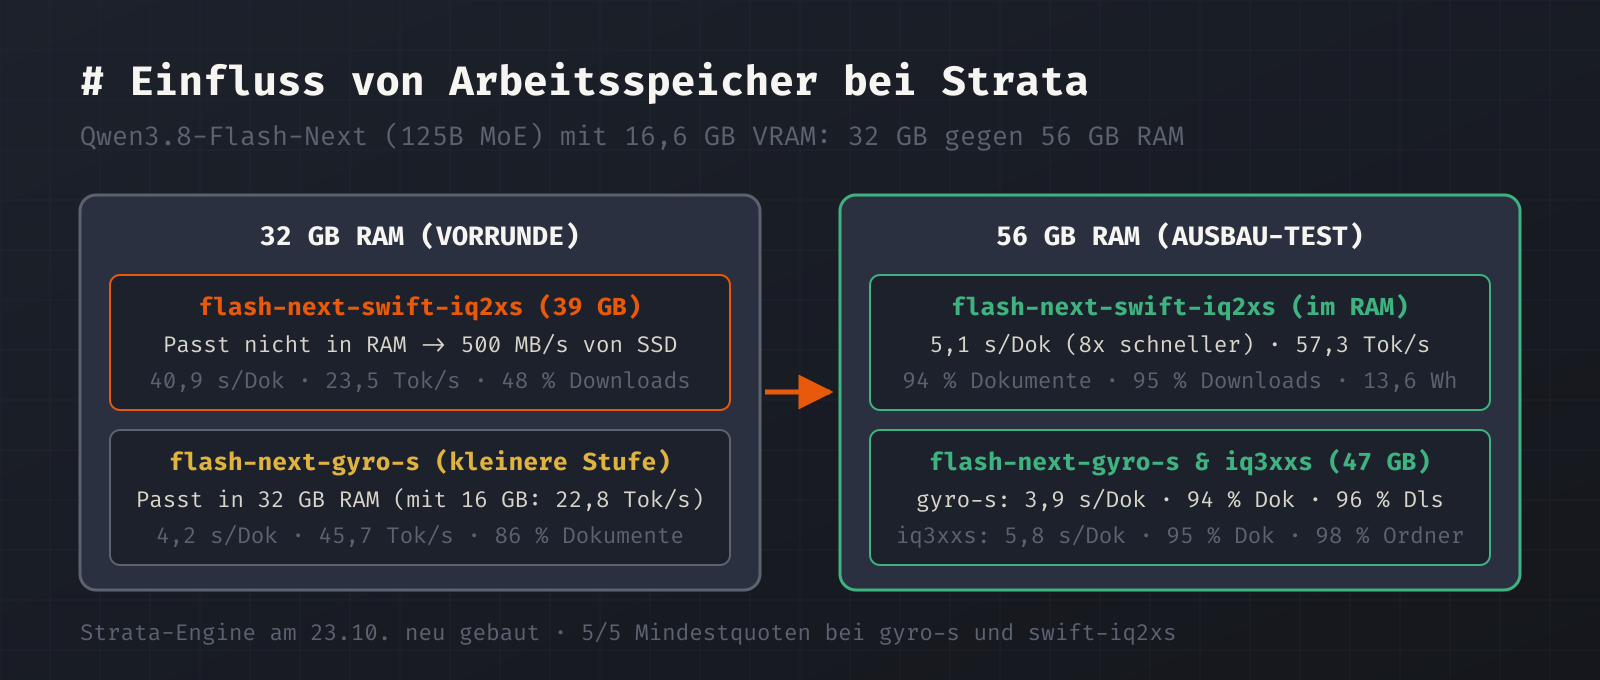
Bevor Knoten 3 später auf 128 GB RAM aufgerüstet wird, wollte ich wissen, wie sich 56 GB RAM in der KI-VM auswirken. Für diesen Testlauf am 23. Oktober habe ich den Backup-Server und den Dateiserver vorübergehend auf einen anderen Proxmox-Knoten verschoben, Frigate gestoppt und den ZFS-ARC auf Knoten 3 auf 1 GB begrenzt.
Bei den Vorbereitungen um 12:01 Uhr stürzte Knoten 3 hart ab, genau in dem Augenblick, als bonsai-2-27b für die Ordner-Nachmessung auf die GPU geladen wurde. Zu diesem Zeitpunkt hingen noch neun Festplatten am selben Netzteil wie das Mainboard und die Grafikkarte. Nachdem die neun HDDs an ein eigenes Netzteil umgezogen waren, lief der Host über zwei Stunden unter voller GPU-Last ohne Unterbrechung durch.
| Modell (56-GB-Lauf) | Dokumente | Betrag | s / Dok | Downloads | Ordner | Fotos | OCR | Token/s | VRAM | Energie |
|---|---|---|---|---|---|---|---|---|---|---|
| flash-next-iq3xxs (47 GB) | 95 % | 95 % | 5,8 s | 85 % | 98 % | – | – | 45,9 | 16,6 GB | 15,1 Wh |
| flash-next-gyro-s | 94 % | 95 % | 3,9 s | 96 % | 98 % | – | – | 51,0 | 16,6 GB | 13,3 Wh |
| flash-next-swift-iq2xs (39 GB) | 94 % | 95 % | 5,1 s | 95 % | 95 % | – | – | 57,3 | 16,6 GB | 13,6 Wh |
| nemotron-3.5-bolt-74b-a9b (50 GB) | 93 % | 95 % | 10,0 s | 65 % | 93 % | 66 % | 100 % | 16,8 | 15,6 GB | 26,6 Wh |
Mit 56 GB RAM liegen alle drei Strata-Stufen vollständig im Arbeitsspeicher. Bei flash-next-swift-iq2xs fällt die Bearbeitungszeit pro Dokument von 40,9 auf 5,1 Sekunden, die Download-Trefferquote steigt von 48 auf 95 Prozent, und der Energieverbrauch sinkt von 32,4 auf 13,6 Wh. Auch die neu hinzugenommene 47-GB-Stufe flash-next-iq3xxs läuft flüssig und erreicht mit 95 Prozent den höchsten Dokumentenwert im gesamten Vergleich, fällt aber bei Downloads auf 85 Prozent zurück. Zur Einordnung gehört, dass die Strata-Engine am 23. Oktober neu gebaut wurde; ein Teil des Qualitätssprungs bei gyro-s und swift-iq2xs kann daher aus dem neuen Engine-Stand stammen.
Weniger überzeugend liefen im 56-GB-Test drei große MoE-Modelle mit Bildteil unter llama.cpp, die mit 32 GB RAM gar nicht erst gestartet waren: Nemotron 3.5 Bolt 74B-A9B (UD-Q4_K_XL, 50 GB), Mistral Small 4 119B (UD-IQ3_S, 44 GB) und Qwen3.5-122B-A10B (UD-IQ3_S, 47 GB). Mit der Standardvorgabe -fitt 768 setzte der Kernel-Treiber die Grafikkarte beim ersten Bild mit amdgpu ring timeout und Vulkan DeviceLost zurück. Erst mit -fitt 3072 (3 GB VRAM frei lassen) blieb der Bildteil auf der GPU stabil, benötigte aber rund 20 Sekunden pro Foto, weil die Verarbeitung der Bild-Token auf die im System-RAM abgelegten Experten wartet. Bei Nemotron 3.5 Bolt 74B-A9B lief die Bildnachmessung nach dem Absturz auf der CPU (32,5 Sekunden pro Bild, 66 Prozent Trefferquote); Bildverarbeitung auf der CPU habe ich daraufhin komplett gestrichen. Mistral Small 4 119B (81 Prozent Dokumente, 50 Prozent Downloads bei 15 Token/s) und Qwen3.5-122B-A10B (85 Prozent Dokumente, 82 Prozent Downloads bei 10 Token/s und rund 17 Sekunden pro Dokument) habe ich vorzeitig abgebrochen und aus der Auswahl genommen.
Auswahl für die Hauptrunde und offene Läufe
Legt man die vorgeschlagenen Mindestquoten an alle bisherigen Läufe an, erfüllen nur flash-next-gyro-s und flash-next-swift-iq2xs im 56-GB-Ausbau sämtliche fünf für reine Textmodelle gemessenen Vorgaben (Dokumente ≥ 90 %, Betrag ≥ 95 %, ≤ 10 s je Dokument, Downloads ≥ 90 %, Ordner ≥ 80 %). Unter den Bildmodellen erreichen qwen3.8-27b und qwen3-vl-8b jeweils vier von sieben Quoten; beiden fehlt vor allem die 95-Prozent-Marke beim Rechnungsbetrag.
Für die Hauptrunde mit dem vollen Testsatz, echten Dokument-Scans statt sauber gerenderter Testseiten und verschiedenen Laufzeit-Optionen habe ich das Feld auf zwölf Finalisten verkleinert: als Allrounder gemma-4-26b-a4b, qwen3.6-35b-a3b, minicpm-v-4.7-35b-a3b und gemma-4-12b, für Fotos qwen3-vl-8b und qwen3.8-27b, für Text und Downloads flash-next-gyro-s, für OCR paddleocr-vl-1.6 und dots.ocr, für Embeddings qwen3-embedding-4b sowie als Vergleichsmaßstab muse-glimmer-30b und bonsai-2-27b.
Der erste Lauf dieser Serie (laufzeit-20261023) ist am 23. Oktober um 13:22 Uhr für gemma-4-26b-a4b unter Vulkan mit aktivierter Flash Attention durchgelaufen: 83 Prozent bei Dokumenten in 2,4 Sekunden pro Dokument, 80 Prozent bei Fotos in 2,5 Sekunden pro Bild, 67,7 Token/s bei 15,2 GB VRAM und 7,2 Wh Energiebedarf. Als Nächstes lege ich die endgültigen Mindestquoten fest und lasse die übrigen elf Finalisten durch den kompletten Testsatz laufen.
Schreibe einen Kommentar