Seit Oktober 2026 liegen meine Aufgabenliste, das Änderungslog, die Entscheidungen und die Roadmap nicht mehr als handgepflegte Markdown-Dateien im Repository, sondern in einer PostgreSQL-Datenbank. Anlass waren die wachsenden Übersichtsseiten und parallele Arbeitssitzungen. Jede Sitzung musste vorher große Markdown-Tabellen komplett einlesen, obwohl sie nur an einem einzigen Aufgabenblock gearbeitet hat. Wenn zwei Sitzungen gleichzeitig liefen, kamen sich Änderungen an derselben Tabellenzeile in die Quere.
Warum Markdown-Tabellen bei parallelen Sitzungen klemmen
Die Dokumentation im Homelab wird laufend von automatisierten Arbeitssitzungen aktualisiert. Jede erledigte Aufgabe, jeder Zwischenstand eines Themenblocks und jeder Eintrag im Änderungslog landete früher direkt in wenigen großen Markdown-Dateien. Mit der Zeit wuchsen diese Dateien so stark an, dass auch der Suchindex der statischen Dokumentationsseite auf 3,1 MB anschwoll.
Für die tägliche Arbeit hatte das zwei Nachteile. Erstens musste eine Sitzung zum Start die gesamte Aufgabenliste einlesen, nur um die offenen Punkte eines einzelnen Blocks zu kennen. Zweitens führten gleichzeitige Schreibzugriffe in denselben Markdown-Tabellen regelmäßig zu Merge-Konflikten im Git, weil sich Zeilennummern und Nachbarzeilen verschoben.
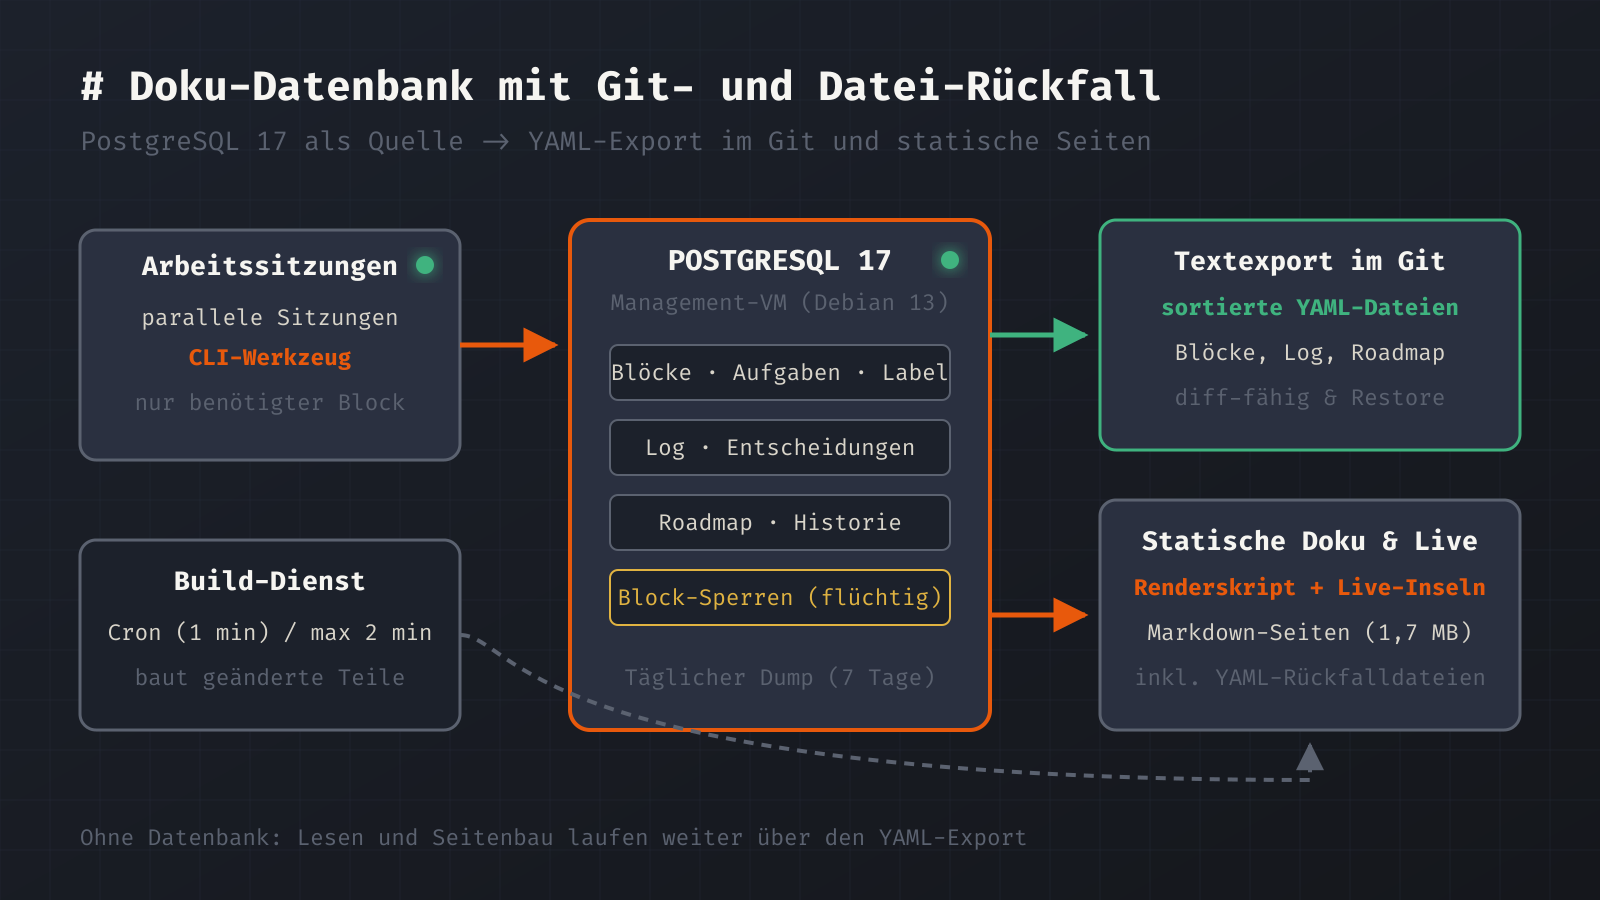
Deshalb habe ich diese Bestandsdaten in eine Datenbank auf PostgreSQL 17 überführt, die auf der Management-VM (Debian 13) läuft. Die bisherigen Seiten für offene Aufgaben, Nebenerwerb und Privates, erledigte Blöcke, Aufgabenblöcke, das Änderungslog und die Entscheidungen bleiben als Markdown-Dateien bestehen. Sie werden aber ausschließlich aus der Datenbank erzeugt und nie mehr von Hand editiert.
Datenbank, Textexport und Werkzeuge
Vier Werkzeuge und das SQL-Schema bilden die Schnittstelle zur Datenbank:
- Ein Kommandozeilenwerkzeug für die Arbeitssitzungen liest einzelne Blöcke, legt Aufgaben an, ändert Statuswerte und schreibt Logeinträge.
- Ein Renderskript erzeugt aus dem Datenbestand die Markdown-Seiten sowie zwei YAML-Rückfalldateien für Aufgabenstatus und Roadmap.
- Ein Exportskript schreibt den gesamten Inhalt in sortierte YAML-Dateien und kann die Datenbank daraus wiederherstellen.
- Das SQL-Schema definiert die Tabellenstruktur einschließlich einer Historientabelle, die bei jeder Änderung protokolliert, wer wann welchen alten Wert durch welchen neuen ersetzt hat.
Damit die Versionsverwaltung im Git erhalten bleibt, exportiert das Kommandozeilenwerkzeug bei jeder schreibenden Änderung automatisch den aktuellen Stand in sortierte YAML-Dateien und erzeugt die Markdown-Seiten neu. Im Exportordner liegen die Inhalte aufgeteilt je Aufgabenblock, das Änderungslog getrennt nach Monaten sowie eigene Dateien für Entscheidungen, Roadmap und Seitentexte. Dieser Textexport gehört in jeden Commit. In Merge-Requests lassen sich Änderungen dadurch zeilenweise vergleichen, ohne dass eine binäre Datenbank im Weg steht.
Gezielter Abruf und Sperren für parallele Sitzungen
Statt zum Start komplette Übersichtsseiten zu laden, ruft eine Sitzung heute über das Kommandozeilenwerkzeug nur noch den Steckbrief ihres Themenblocks ab. Das sind wenige Kilobyte mit Ziel, aktuellem Stand, relevanten Orten, bekannten Fallstricken, den offenen Aufgaben und dem jüngsten Verlauf. Über dieselbe Schnittstelle legt die Sitzung neue Aufgaben an, setzt erledigte Punkte um und schreibt am Ende ihren Stand sowie den Eintrag für das Änderungslog zurück.
Um zu verhindern, dass zwei Sitzungen gleichzeitig denselben Aufgabenblock bearbeiten, gibt es eine explizite Block-Sperre. Eine Sitzung sperrt ihren Themenblock beim Start in einer eigenen Sperrtabelle, die die Sitzungs-ID und den Startzeitpunkt vermerkt. Da diese Sperren nur für den laufenden Betrieb gelten, sind sie flüchtig und werden nicht in die YAML-Dateien exportiert.
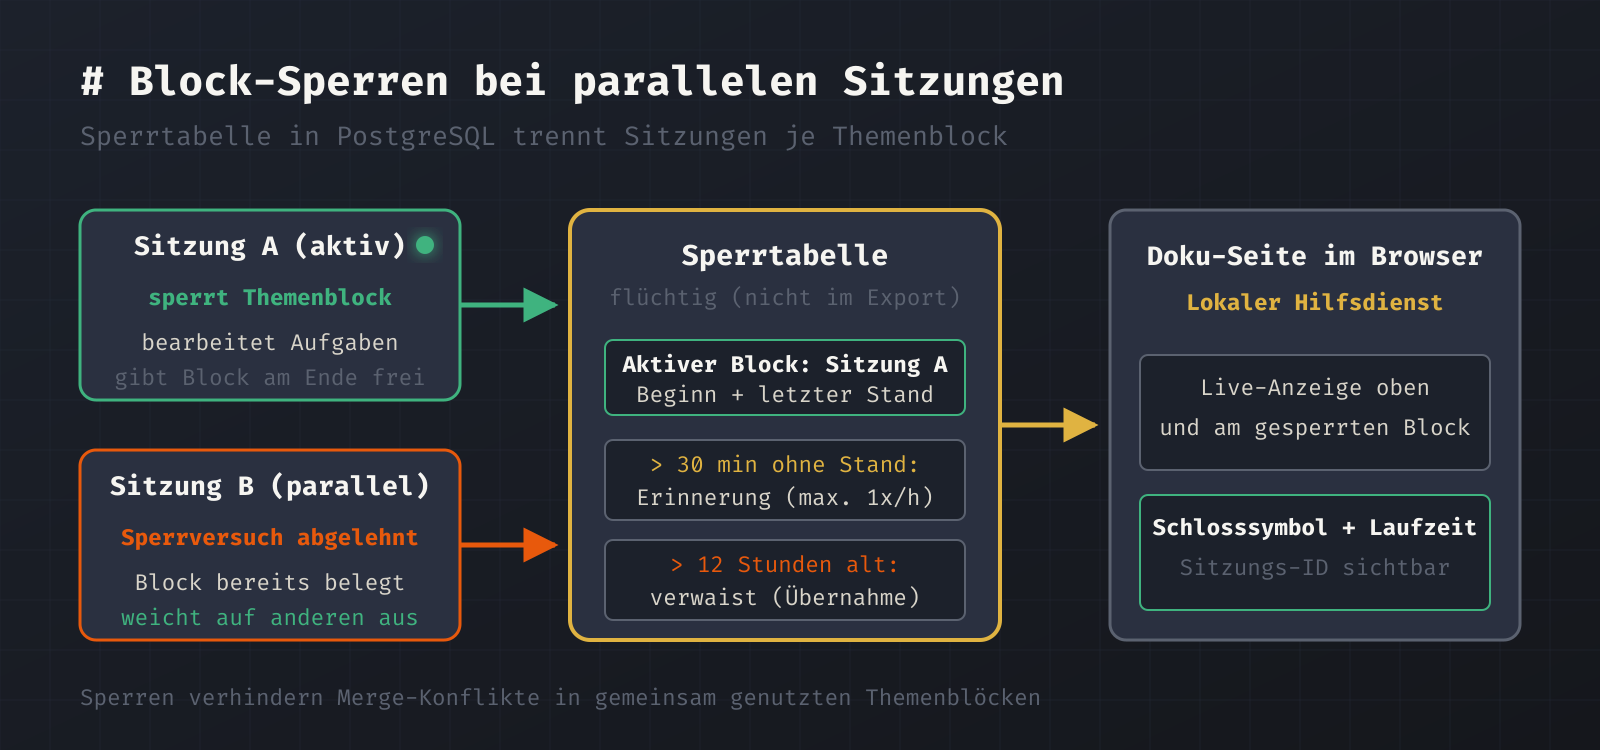
Versucht eine zweite Sitzung denselben Block zu sperren, bricht der Aufruf mit einem eigenen Exit-Code ab, und beim Lesen des Blocks erscheint eine Warnung. Vergisst eine Sitzung am Ende das reguläre Entsperren, greifen zwei Mechanismen: Ein lokaler Prüfmechanismus erinnert höchstens einmal pro Stunde daran, wenn ein Block länger als 30 Minuten gehalten wird, ohne dass sein Stand aktualisiert wurde. Nach 12 Stunden gilt eine Sperre automatisch als verwaist und wird von der nächsten Sitzung übernommen.
Zusätzlich sind aktive Sperren direkt in der Dokumentation im Browser sichtbar. Über einen lokalen Hilfsdienst fragt die Webseite die aktiven Sperren ab und zeigt oben auf der Aufgaben- und Blockliste ein Schlosssymbol samt Sitzungs-ID und Laufzeit an.
Aufgaben nach Priorität, Aufwand und Nutzen filtern
Mit dem Umzug in relationale Tabellen ließen sich Eigenschaften abbilden, die in reinen Markdown-Listen unhandlich waren. Jeder Aufgabenblock besitzt ein Überthema (Infrastruktur, Dienste, Verwaltung oder Nebenerwerb). Es steuert, unter welchem Reiter der Block in der Aufgabenliste auftaucht. Blöcke aus dem Bereich Nebenerwerb landen auf einer eigenen Seite. Sobald in einem Block alle Aufgaben erledigt sind, verschiebt ihn das Renderskript automatisch auf die Seite der erledigten Blöcke; kommt später eine neue offene Aufgabe hinzu, kehrt er zurück. Alte Sprungmarken auf die Hauptseite bleiben über Weiterleitungen im Seitenskript funktionsfähig.
Bei den Prioritäten habe ich die bisherigen drei Ampelfarben durch eine feinere Skala von 1 (am dringendsten) bis 10 (irgendwann) ersetzt. Bei der Migration wurden bestehende rote Einträge auf 2, gelbe auf 5 und grüne auf 8 gesetzt. Die Ampelspalte existiert weiterhin für die schnelle Übersicht, wird aber nur noch automatisch aus der Zahlenstufe abgeleitet (1 bis 3 ist Rot, 4 bis 6 Gelb, 7 bis 10 Grün) und nie direkt beschrieben.
Dazu kamen zwei Felder für den geschätzten Aufwand (klein für unter 30 Minuten, mittel für eine Sitzung, gross für mehrere Sitzungen) und den Nutzen (hoch, mittel, gering). Aus dieser Kombination berechnet die Datenbank automatisch ein Label:
| Nutzen \ Aufwand | klein (< 30 min) | mittel (1 Sitzung) | gross (mehrere Sitzungen) |
|---|---|---|---|
| hoch | quickwin | lohnt | lohnt |
| mittel | quickwin | normal | teilen |
| gering | nebenbei | nebenbei | streichen |
Ein weiteres Label namens grundlage wird nicht gespeichert, sondern dynamisch vergeben, sobald ein anderes Arbeitspaket mit offenen Aufgaben auf das aktuelle Paket als Voraussetzung wartet. Wenn ich zwischendurch eine halbe Stunde Zeit habe, liefert mir eine Abfrage nach dem Label quickwin sofort alle kleinen Aufgaben mit hohem oder mittlerem Nutzen.
Für Aufgaben, die eine Entscheidung oder Vorarbeit von mir als Administrator erfordern, gibt es eine eigene Übersichtsseite („Dein Anteil“). Dort speichert die Datenbank die Art der Mitwirkung (zum Beispiel entscheiden, freigeben oder selbst), einen Kurztitel, vorbereitete Optionen samt Empfehlung und ein Wiedervorlage-Datum. Wähle ich im Browser eine Option aus oder gebe eine Aufgabe frei, speichert der lokale Hilfsdienst die Antwort in einer Eingangstabelle und setzt den Status auf freigegeben, sodass die nächste Arbeitssitzung direkt weitermachen kann.
Statische Seiten mit Live-Inseln und Build-Dienst
Obwohl die Daten aus PostgreSQL kommen, bleibt die Dokumentation im Kern eine statisch gebaute Webseite. Das hat den Vorteil, dass alle Prüfungen unverändert weiterlaufen und die Seiten auch dann lesbar sind, wenn die Datenbank nicht läuft. Um trotzdem keine veralteten Stände zu sehen, nutzen die Seiten sogenannte Live-Inseln: Ein kleines JavaScript lädt beim Öffnen im Browser die veränderlichen Felder (Aufgabenstatus, Priorität, den Kasten „Stand und nächster Schritt“ auf Planseiten sowie neue Einträge in Log und Entscheidungen) live über den lokalen Hilfsdienst nach.
Zwei Anpassungen haben dabei die Ladezeiten und den Build-Ablauf deutlich beschleunigt:
- Erledigte Aufgaben stehen nicht mehr direkt im HTML der Hauptlisten. Stattdessen erzeugt das Renderskript pro Block eine eigene Teil-Datei, die im Browser erst auf Knopfdruck oder beim Setzen eines entsprechenden Filters nachgeladen wird. Ohne JavaScript bleibt eine vollständige Ansicht erreichbar.
- Die automatisch erzeugten Großseiten (Aufgabenliste, Änderungslog, Entscheidungen, Roadmap, Blockübersicht, Hostseiten) werden beim Bauen aus dem statischen Suchindex herausgehalten. Für diese Inhalte gibt es eine direkte Datenbanksuche im Browser und auf der Kommandozeile. Dadurch schrumpfte der statische Suchindex von 3,1 MB auf 1,7 MB.
Außerdem müssen Arbeitssitzungen am Ende nicht mehr selbst den kompletten Seitenbau anstoßen. Ein minütlicher Cron-Job prüft im Hintergrund, ob sich Datenbestände oder Dokumentationsdateien geändert haben, und baut höchstens alle zwei Minuten gezielt nur die betroffenen Teile neu. Während des nächtlichen Backup-Fensters oder wenn bereits der große Tageslauf aktiv ist, pausiert dieser Build-Dienst und lässt sich bei Wartungsarbeiten per Statusdatei abschalten.
Rückfall auf Dateien und Wiederaufbau im Ernstfall
Eine Dokumentation, die bei einem Datenbankausfall nicht mehr benutzbar ist, taugt im Notfall nichts. Deshalb ist der gesamte Unterbau so ausgelegt, dass Lesezugriffe und Seitenbau jederzeit ohne PostgreSQL auskommen. Ist die Datenbank nicht erreichbar oder der datenbanklose Modus per Umgebungsvariable aktiviert, geben die Werkzeuge lediglich einen kurzen Hinweis aus und fallen automatisch auf die zuletzt erzeugten Seiten, den YAML-Export sowie die YAML-Rückfalldateien zurück. Auch die Live-Inseln im Browser fangen Verbindungsfehler ab, lassen den statischen Stand stehen und blenden darunter nur eine kurze Notiz ein. Lediglich neue Schreibvorgänge sind blockiert, bis die Datenbank wieder läuft.
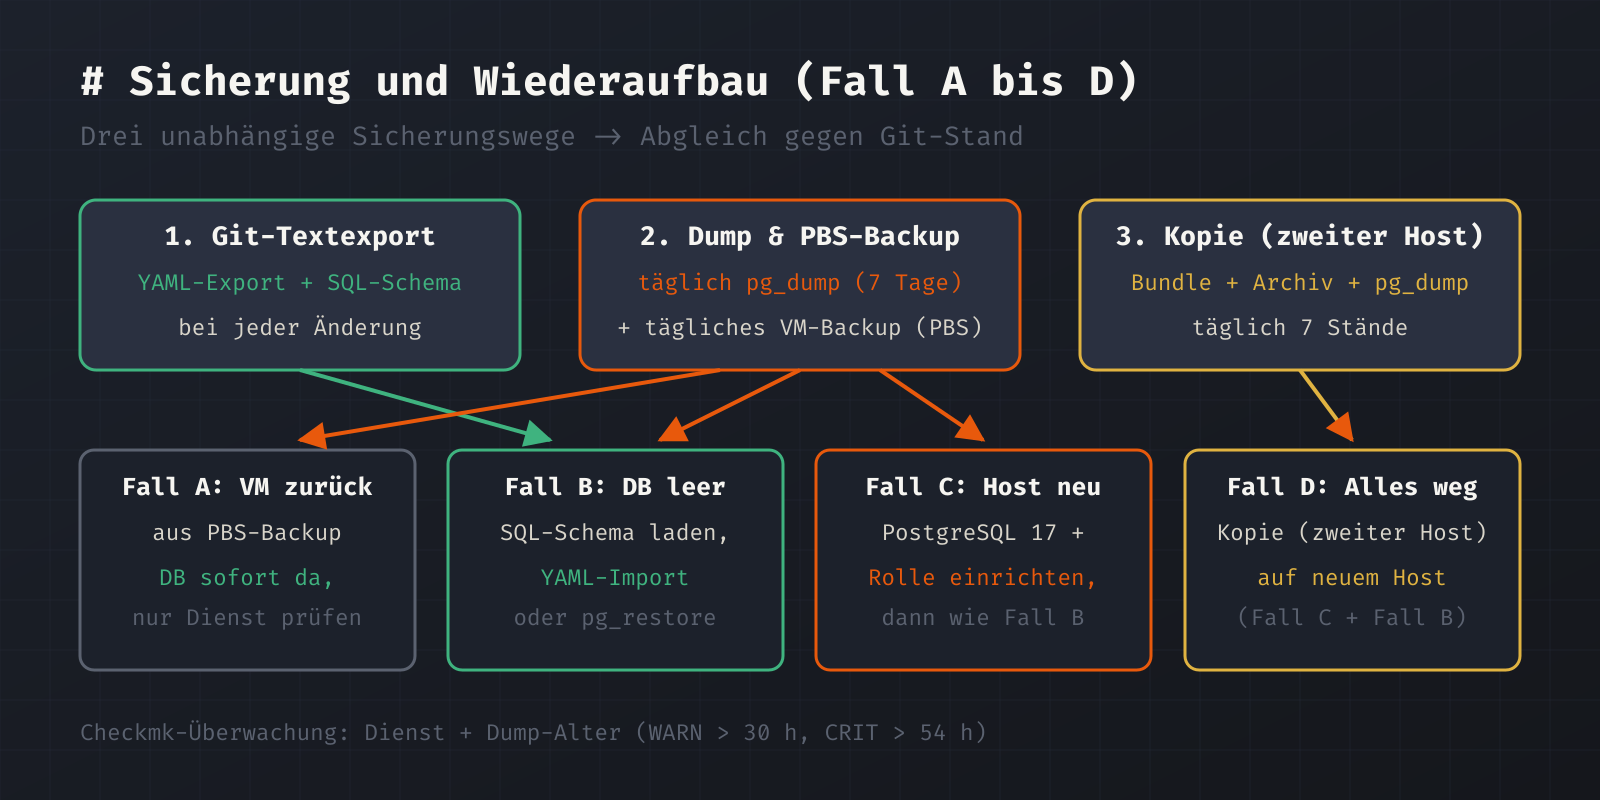
Gesichert wird auf drei Wegen: Bei jeder Änderung landen die YAML-Dateien im Git-Repository. Zusätzlich erstellt ein Timer auf der Management-VM täglich einen binären Abzug per pg_dump mit sieben Tagen Vorhaltezeit, während die gesamte VM im täglichen Lauf des Proxmox Backup Servers gesichert wird. Ein dritter Weg legt täglich ein Paket aus Git-Bundle, YAML-Export und Datenbank-Dump in sieben Ständen auf einem zweiten Host ab. Ein Checkmk-Check überwacht sowohl die Erreichbarkeit der Datenbank als auch das Alter der Sicherungen und schlägt bei einem zu alten Dump mit einer Warnung (ab 30 Stunden WARN, ab 54 Stunden CRIT) an.
Je nachdem, was ausgefallen ist, gibt es vier feste Wege für den Wiederaufbau:
| Szenario | Vorgehen zur Wiederherstellung |
|---|---|
| Fall A: Management-VM aus Backup zurück | Die Datenbank kommt komplett mit der VM aus dem Proxmox Backup Server zurück. Nur den Dienststatus (systemctl status postgresql@17-main) und die Datenbankabfrage prüfen. |
| Fall B: Datenbank verloren, Server intakt | Leere Datenbank anlegen, die Tabellenstruktur aus dem SQL-Schema laden und danach den Datenbestand entweder aus den YAML-Dateien im Git oder per pg_restore aus dem täglichen Dump einspielen. |
| Fall C: Server komplett neu aufbauen | Auf der Management-VM oder einem anderen Debian-13-Host postgresql-17 installieren, Datenbankrolle und Datenbank anlegen, dann weiter wie in Fall B. Anschließend den täglichen Dump-Timer und die Checkmk-Überwachung aktivieren. |
| Fall D: Management-VM und Backup-Server weg | Auf einem zweiten Host liegen die täglichen Kopien der letzten 7 Tage (Git-Bundle, Archiv mit den YAML-Dateien und der pg_dump-Abzug). Auf einem beliebigen Debian-Host PostgreSQL wie in Fall C installieren und den Bestand aus diesen Dateien einspielen. |
Nach einer Wiederherstellung in Fall B, C oder D prüft ein Abgleichwerkzeug in einem Durchlauf, ob die aus der wiederhergestellten Datenbank erzeugten Markdown-Seiten bytegenau mit dem Stand im Git übereinstimmen.
Schreibe einen Kommentar