Jede Homelab-Doku fängt gut an. Man schreibt auf, welche VM welche Adresse hat, welcher Dienst wo läuft, wie man ihn zurückholt. Ein halbes Jahr später stimmt die Hälfte nicht mehr: Eine VM ist umgezogen, eine Adresse hat sich geändert, ein Dienst ist weggefallen, und niemand hat alle Stellen nachgezogen, an denen er erwähnt war. Bei mir war das nicht anders. Als ich einmal nachgezählt habe, nannten 48 von 71 handgeschriebenen Seiten feste IP-Adressen, und dieselben Dienste standen in acht verschiedenen Listen, jede von Hand gepflegt. Hier steht, wie ich das umgebaut habe: ein Asset-Register als einzige Quelle, daraus erzeugte Seiten, eine tägliche Prüfung gegen die echten Systeme und Runbooks für den Wiederaufbau.
Das Werkzeug: MkDocs und ein Git-Repository
Meine Doku besteht aus Markdown-Dateien in einem Git-Repository. Daraus baut MkDocs mit dem Material-Theme eine statische Website, die ein Webserver im Heimnetz ausliefert. Markdown kann jeder Editor, Git liefert den Verlauf jeder Änderung mit, und weil MkDocs beim Bau Python-Code ausführen kann, lässt sich die Doku mit Skripten verbinden. Darauf baut alles Weitere auf.
Woher ein Fakt kommen darf
Bevor ich irgendetwas programmiert habe, habe ich aufgeschrieben, woher ein Fakt kommen darf. Die Regel hat drei Stufen:
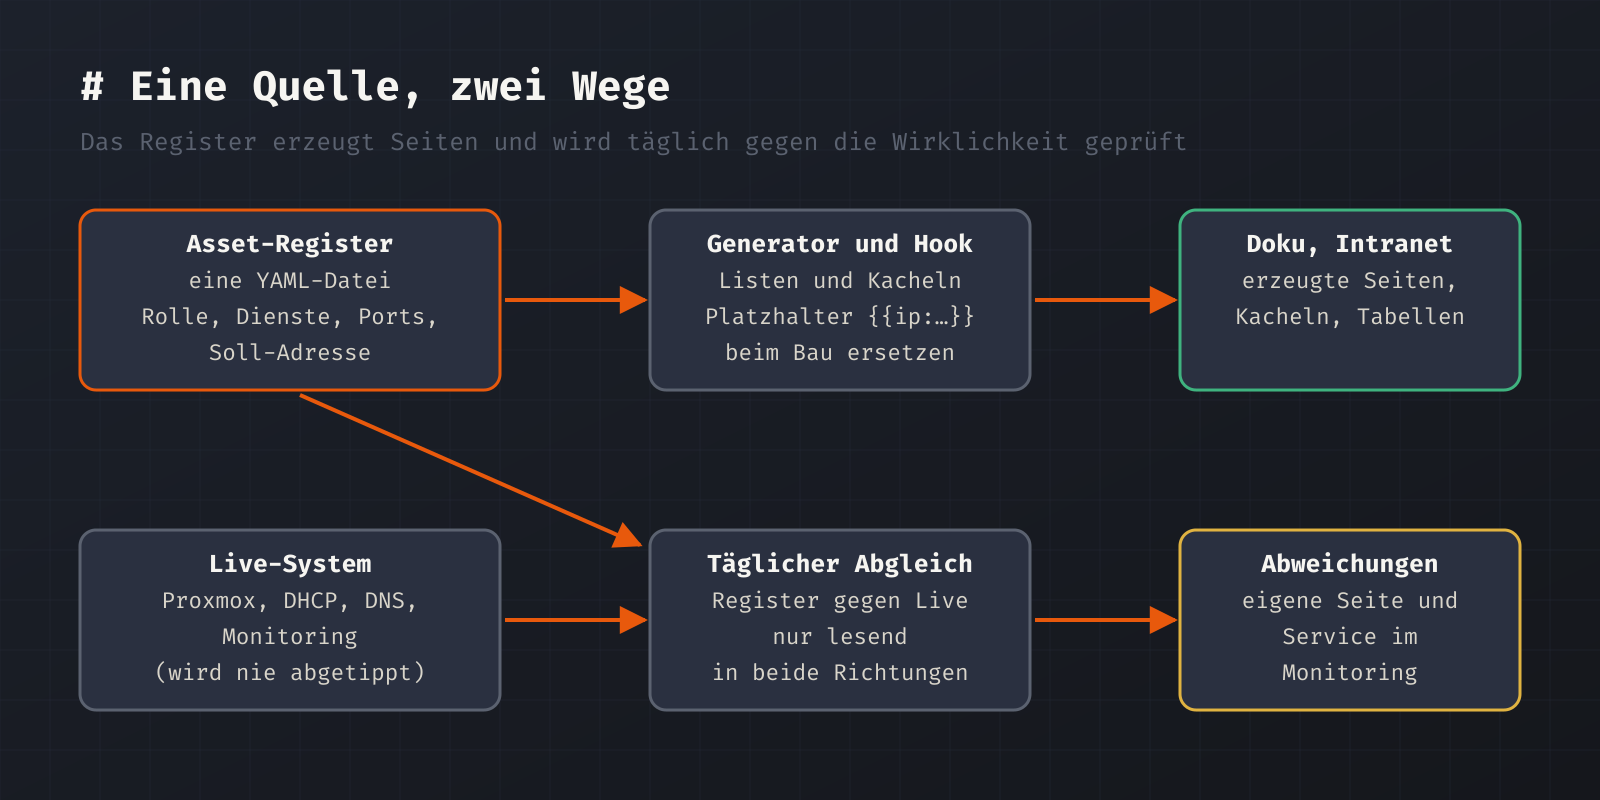
- Fakten kommen aus dem Live-System. Ob eine VM existiert, auf welchem Knoten sie läuft, welche DHCP-Reservierung oder welcher DNS-Eintrag besteht, was das Monitoring meldet: Das wird nie abgetippt, sondern von Inventarskripten gelesen.
- Absicht steht im Asset-Register. Was sich nicht ablesen lässt, gehört in eine einzige YAML-Datei: Rolle, Dienste und Ports, Soll-Adresse, DNS-Namen, ob gesichert werden muss, wie kritisch etwas ist, wo die Doku dazu liegt.
- Alles andere ist abgeleitet. Listen werden aus dem Register erzeugt oder dagegen geprüft.
Dazu kommt eine Regel ohne Ausnahme: keine Geheimnisse, weder im Register noch in den Seiten. Dort stehen nur Orte und Namen, also zum Beispiel, in welcher Datei ein Kennwort liegt, aber nie das Kennwort selbst.
Das Asset-Register
Das Register ist bewusst eine einzige Datei. Ein Eintrag sieht vereinfacht so aus (Namen hier allgemein gehalten):
assets:
  management:
    typ: vm
    vmid: 200
    rolle: "Monitoring, Doku, Intranet"
    ip: "…"                  # Soll-Adresse, wird gegen DHCP, DNS, Proxmox geprüft
    dns: [management, monitoring, docs]
    kritikalitaet: hoch
    backup: {pbs: true, konfig: true}
dienste:
  monitoring:
    asset: management
    name: Monitoring
    port: 443
    kachel: true             # erscheint im Intranet
    zertifikat: {handler: apache}
Ein neuer Dienst braucht genau einen Eintrag. Daraus entstehen die Kachel im Intranet, das Ziel für die automatische Zertifikatserneuerung, die Zeile in der Abhängigkeitskarte und der Erfassungsstand. Nach dem ersten Import hatte das Register 116 Assets: drei Proxmox-Knoten, 13 VMs, sechs Container und 94 Geräte. Inzwischen sind es 135, davon zwölf Container und 107 Geräte. Die IoT-Geräte stehen einzeln drin, nicht als Gruppe. Die MAC-Adressen stehen nicht drin, denn die Wahrheit dafür ist die DHCP-Reservierung.
Ich habe nicht von null angefangen, sondern ein Importskript geschrieben, das das Register einmalig aus allen bestehenden Listen zusammensetzt. Widersprüche zwischen den alten Listen hat es aufgelistet, und die habe ich von Hand geklärt. Danach wird nur noch das Register gepflegt.
Erzeugte Seiten und Listen
Ein Generator läuft als erster Schritt jedes Doku-Baus und schreibt aus dem Register unter anderem:
- die Kacheln des Intranets mit Gruppen und Downloads,
- den Erfassungsstand (welche Gäste sind wie gut dokumentiert),
- die Abhängigkeitsliste und die Stromkreise,
- die Zielliste für die Zertifikatserneuerung,
- die IP-Tabelle im Netzplan und die Tabelle der Adressblöcke im Adressplan,
- einen Vorschlag für die SSH-Konfiguration, als separate Datei, die echte Konfiguration wird nicht überschrieben.
Bevor ich eine Liste umgestellt habe, lief eine Vergleichsprobe: Die erzeugte Datei musste der bisherigen handgepflegten Datei entsprechen. Bei der Abhängigkeitsliste kam dabei ein alter Fehler heraus, ein Name war an einem Komma abgeschnitten worden. Bei der Zertifikatsliste zeigte die Probe einen Einrückungsfehler im YAML. Seitdem liest die Probe den geschriebenen Text zurück, statt nur die berechneten Daten zu vergleichen. Und als die Tabelle der Adressblöcke zum ersten Mal erzeugt wurde, fiel auf, dass ein Gerät mit fester Adresse im Register fehlte. Ich stelle deshalb immer nur eine Liste auf einmal um und vergleiche vorher und nachher.
Jede erzeugte Datei trägt einen Kopf mit dem Hinweis, dass sie erzeugt ist und nicht von Hand geändert werden darf. Das allein hält niemanden ab. Deshalb überschreibt der Generator eine Datei nicht, wenn jemand sie doch von Hand geändert hat. Er meldet stattdessen einen Konflikt und lässt sie stehen. So geht keine Änderung stillschweigend verloren, und der Fehler wird sichtbar: Die Änderung gehört ins Register.
Keine festen Adressen im Fließtext
Die meisten veralteten Angaben steckten nicht in Listen, sondern im Fließtext: „Melde dich per SSH an der Adresse … an.“ Dafür habe ich einen kleinen MkDocs-Hook in reinem Python geschrieben. Statt einer Adresse steht im Markdown ein Platzhalter, und der Hook ersetzt ihn beim Bau durch den Wert aus dem Register:
ssh root@{{ip:management}}
Die VM mit der ID {{vmid:management}} heißt {{name:management}}.
Das funktioniert überall, auch in Codeblöcken, Links, Überschriften und Diagrammen. Unbekannte Platzhalter bleiben stehen und werden beim Bau gemeldet. Ein Hilfsskript setzt die Platzhalter halbautomatisch, aber vorsichtig: Im Fließtext nur, wenn die Zeile den Namen des Assets nennt. Sonst würde eine historische Aussage wie „früher lief das auf einer anderen Adresse“ plötzlich am falschen Gerät hängen. Vor und nach der Umstellung habe ich den gerenderten Text aller betroffenen Seiten verglichen, er war identisch. Am Ende waren es null ungeschützte Adressen; ein paar Bereichsangaben und historische Sätze sind bewusst fest und ausdrücklich markiert.
Für Zahlen gilt dasselbe. Wie viele Gäste gesichert werden, steht nicht als feste Zahl im Text, sondern als Marke, die ein Skript bei jedem Lauf aus dem Inventar füllt.
Automatische Konsistenzprüfung
Erzeugen allein reicht nicht, denn das Register kann selbst falsch sein. Deshalb gleicht ein Prüfskript es täglich in beide Richtungen mit der Wirklichkeit ab, nur lesend. Gemeldet wird zum Beispiel:
- ein Gast in Proxmox ohne Eintrag im Register und umgekehrt,
- eine Soll-Adresse, die nicht zur DHCP-Reservierung oder zum DNS-Eintrag passt,
- ein Host, der im Monitoring fehlt,
- ein Webdienst im Netzwerkscan, den das Register nicht kennt,
- eine Seite mit einer festen Adresse, die das Register anders kennt.
Gastadressen bestätigt der Abgleich über die MAC-Adresse aus der Gast-Konfiguration und die ARP-Tabellen. Das Ergebnis landet auf einer eigenen Seite und als Service im Monitoring: OK bei null Abweichungen, Warnung ab einer, kritisch ab sechs oder wenn der Abgleich zu alt ist. Der erste Lauf fand drei Abweichungen und fünf Hinweise, darunter einen Server, der im Monitoring fehlte.
Zusätzlich prüft eine Pipeline in GitLab jede Änderung auf dem Hauptzweig: Sind alle YAML-Dateien und Skripte syntaktisch in Ordnung? Entsprechen die erzeugten Listen dem Register? Und ist versehentlich ein Schlüssel, Token oder Kennwort ins Repository geraten?
Eine Startseite nur aus Daten
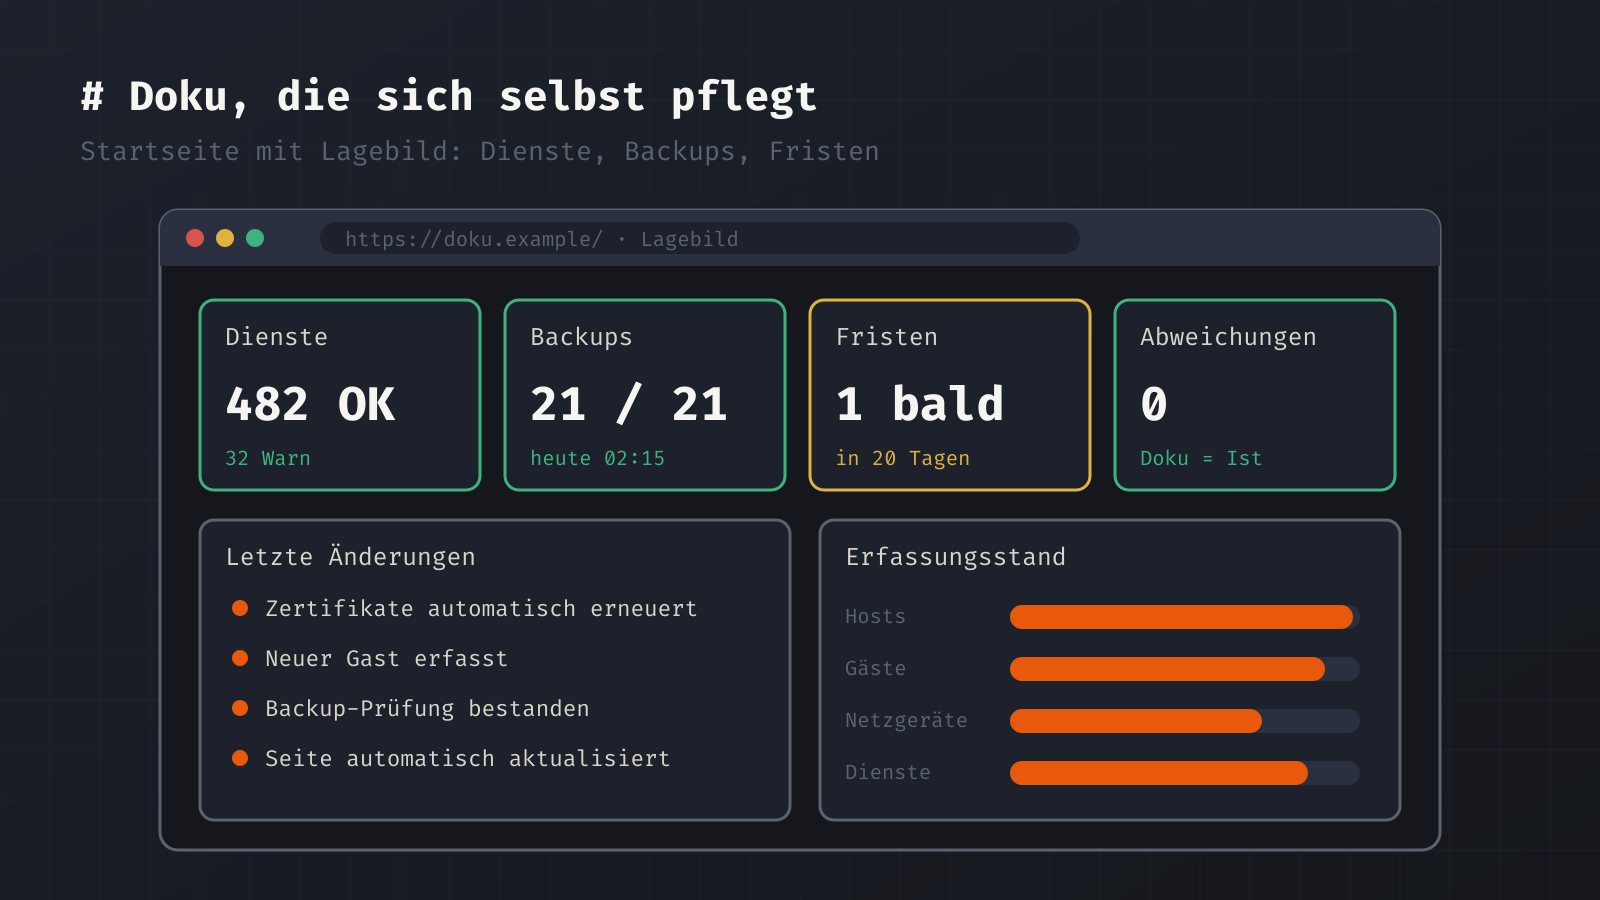
Die Startseite der Doku ist ein Lagebild, und dort gilt: nichts von Hand. Jeder Baustein stammt aus einer Quelle und zeigt sein Alter, etwa der Dienstzustand, offene Probleme aus dem Monitoring, Quorum und Replikation des Clusters, das Backup je Gast, Fristen und Abweichungen. Ist eine Quelle älter als ihr Takt plus Puffer, wird der Baustein grau und sagt, seit wann er veraltet ist. Ein Skript schreibt dafür stündlich eine JSON-Datei, die die Seite liest.
Auch handgeschriebene Seiten zeigen unter der Überschrift, wann sie zuletzt geändert und wann inhaltlich geprüft wurden. Ist beides zu alt, erscheint ein farbiger Hinweis: Inhalt vor Gebrauch gegen das Live-System prüfen. Eine Doku, die immer gleich zuversichtlich aussieht, wäre unehrlicher.
Regeln, die den Rest zusammenhalten
Vier Schreibregeln verhindern, dass sich Fakten wieder verteilen. Zu jedem Thema gibt es eine Hauptseite; alle anderen Seiten verlinken dorthin, statt Werte zu kopieren. Jede Aussage über einen Zustand trägt ein Datum, und was kein Datum hat, soll dauerhaft gelten. Auf den Seiten der Systeme stehen keine Häkchen und kein „erledigt“: Der Status lebt in der Aufgabenliste, der Verlauf im Änderungslog. Und Anleitungen für alle im Haus, etwa wie man ein Handy einrichtet, stehen im Intranet, alles für den Betrieb in der Doku; der jeweils andere Ort verlinkt nur.
Runbooks für den Wiederaufbau
Der wichtigste Teil der Doku ist der, den man hoffentlich nie braucht. Für den Fall, dass alles neu aufgebaut werden muss, gibt es eine Seite mit der Reihenfolge und je Stufe ein Runbook. Dabei unterscheide ich zwei Wege. Ist der Backup-Server mit seiner Datenplatte noch da, kommen die Gäste aus der Sicherung zurück: schnell und mit Daten. Die Neubau-Anleitungen in den einzelnen Runbooks sind der Rückfall, wenn eine Sicherung fehlt oder unbrauchbar ist.
Die Reihenfolge: Netzwerk-Hardware, dann der Proxmox-Cluster, direkt danach der Backup-Server, dann zuerst Firewall und Domänencontroller. Erst danach folgen Linux-VMs, Zertifizierungsstelle, Monitoring, GitLab und der Rest. Jede Seite nennt, wovon sie abhängt.
Befehle und Werte in den Runbooks stammen aus dem Inventar und der Konfigurationssicherung, nicht aus dem Gedächtnis. Was ich nicht prüfen konnte, ist ausdrücklich als ungeprüft markiert, und für jede Lücke gibt es eine Aufgabe. Ein Hinweis oben in der Wiederaufbau-Übersicht nennt die Grenzen der Sicherung: Der Backup-Speicher hängt am selben Host wie viele Gäste, und eine Kopie außer Haus fehlt noch.
Schreibe einen Kommentar