Bevor ich im Homelab nachts einen Container neu starte oder ein längeres Wartungsskript anstoße, musste ich bisher an sechs Stellen gleichzeitig nach laufenden Aufgaben suchen: in Crontabs, systemd-Timern, den Proxmox-Sicherungsplänen, auf dem Backup-Server, in GitLab und in der Windows-Aufgabenplanung. Lange hatte ich mir mit einer starren Sperrzeit zwischen 02:00 und 04:00 Uhr in einem Hilfsskript beholfen. Inzwischen beantwortet ein zentraler Betriebskalender in einer Datenbank auf dem Admin-Container die Frage „Darf ich jetzt an diesem System arbeiten?“ mit einem einzigen Aufruf – und verhindert so unpassende Eingriffe oder Neustarts während laufender Sicherungen.
Eine Abfrage statt Bauchgefühl
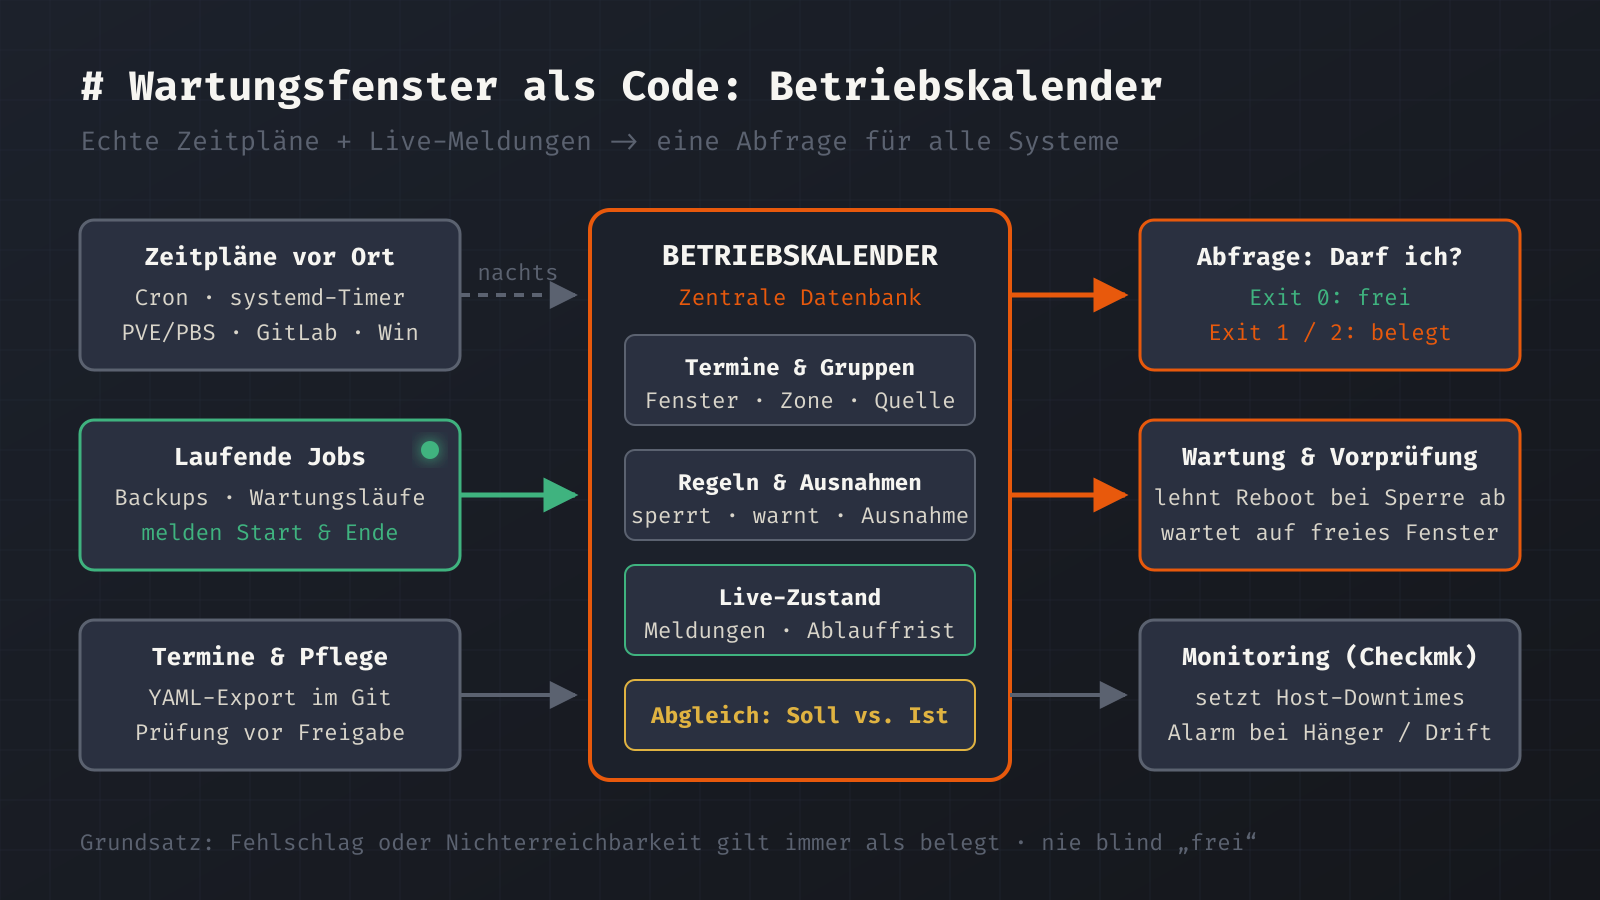
Die Zeitpläne selbst bleiben dort, wo das jeweilige Betriebssystem sie ausführt; ein zentraler Job-Runner per SSH wäre mir zu fehleranfällig gewesen. Der Kalender zieht stattdessen das Wissen über geplante Fenster, Abhängigkeiten und aktuell laufende Jobs in einer Datenbank zusammen. Vor einem Eingriff fragt ein Skript auf dem Admin-Container mit dem gewünschten Zielsystem oder einer Systemgruppe, der geplanten Arbeitsart und der voraussichtlichen Dauer in Minuten an. Geprüft wird also nicht nur der aktuelle Moment, sondern ob das gesamte Vorhaben noch vor dem nächsten sperrenden Fenster abgeschlossen ist und ob alle Vorbedingungen hintereinandergeschalteter Aufgaben erfüllt sind.
Für aufrufende Skripte entscheidet allein der Rückgabewert der Abfrage: Exit-Code 0 bedeutet, dass das Zeitfenster frei ist und die Arbeit starten darf; bloße Hinweise der Stufe „warnt“ werden trotzdem ausgegeben. Exit-Code 1 meldet ein belegtes Fenster und nennt jede greifende Sperre. Exit-Code 2 steht für einen Fehler bei der Abfrage selbst – etwa wenn die Datenbank nicht erreichbar ist, das System im Bestandsverzeichnis fehlt oder Parameter nicht stimmen. Dieser Fehlercode gilt zwingend als belegt. Das war die wichtigste Festlegung beim Bau: Ein kaputter oder nicht erreichbarer Kalender darf niemals „frei“ melden.
In der Datenbank liegen die Stammdaten für geplante Termine, Systemgruppen, Kollisionsregeln und genehmigte Ausnahmen, die zusätzlich versioniert als YAML-Datei ins Git-Repository exportiert werden. Daneben nehmen flüchtige Tabellen die laufenden Start- und Endmeldungen der Jobs sowie spontan gesetzte Wartungsmodi auf, ohne in der Versionsverwaltung zu landen. Neue Termine durchlaufen vor der Freigabe automatisch eine Pflichtfeld- und Kollisionsprüfung gegen die kommenden Wochen.
Welche Arbeiten sich am selben Zielsystem vertragen, geben wenige Grundregeln vor: Ein laufendes oder geplantes Backup sperrt am betroffenen System jede andere Arbeit, und auch Wartungen sowie Migrationen schließen sich gegenseitig und gegenüber automatischen Läufen aus. Reine Prüfjobs dürfen dagegen parallel zu einer Wartung oder Migration weiterlaufen und erzeugen lediglich eine Warnung. Als exklusiv markierte Termine dulden überhaupt keine Überschneidung, und ein aktiv gesetzter Wartungsmodus blockiert alles außer weiterer Wartungsarbeit.
Was beim Zusammenlegen der Zeitpläne schiefging
Als ich die bestehenden Zeitpläne aus meiner bisherigen Übersicht und den Crontabs in die Datenbank übertragen habe, fielen sofort drei Probleme auf, die in getrennten Listen jahrelang übersehen worden waren.
Das erste Problem waren fehlende Endzeiten. Eine crontab kennt nur den Startzeitpunkt. Um überhaupt auf Überschneidungen prüfen zu können, hatte ich beim ersten Eintragen großzügige Schätzwerte für das späteste Ende hinterlegt – für die nächtliche Sicherung etwa den Bereich innerhalb des bisherigen Sperrfensters von 02:00 bis 04:00 Uhr. Prompt meldete die Kollisionsprüfung mehrere Konflikte: Einzelne Datenbank-Dumps lagen mitten im geschätzten Sicherungsfenster des Backup-Servers. Auf dem GitLab-Server startete das Abholen des Backup-Archivs zu einer festen Uhrzeit kurz nach dem Sicherungslauf, ohne zu prüfen, ob das Backup bereits fertig geschrieben war. Und am Monatsersten lief die monatliche Verifikation auf dem Backup-Server rechnerisch in die nachfolgenden täglichen und wöchentlichen Aufräumläufe hinein.
Das zweite Problem war der Zeitzonen-Mischbetrieb über die Systeme hinweg. Die Crontabs auf dem Admin-Container und auf dem GitLab-Server liefen in UTC, während Hypervisoren, Backup-Server, Management-Host und Windows-Server in Europe/Berlin rechneten. Ein fest in UTC eingetragenes Wartungsfenster auf den Hypervisoren berührte in der Sommerzeit nur den Rand des nächtlichen Backup-Fensters zwischen 02:00 und 04:00 Uhr Ortszeit, rutscht aber mit der Umstellung auf Normalzeit Ende Oktober um eine Stunde nach hinten – und damit genau über die laufende Gesamtsicherung. Noch tückischer verhielten sich einzelne Aufgaben in der Windows-Aufgabenplanung auf den Domänencontrollern und dem Dateiserver: Dort war beim Anlegen der Haken „Über Zeitzonen synchronisieren“ gesetzt worden, was im Trigger einen festen UTC-Versatz von +02:00 aus der Sommerzeit verankert hat. Nach dem Wechsel auf Normalzeit laufen solche Aufgaben in Ortszeit plötzlich eine Stunde früher los. Jeder Termin im Betriebskalender führt deshalb seine eigene Zeitzone mit.
Drittens zeigte sich eine Lücke bei den Ausnahmen: Der Berechnungskern prüft Kollisionen immer für ein einzelnes System. Als ich eine Ausnahme für zwei Knoten gleichzeitig als kommagetrennte Liste hinterlegen wollte, griff sie nicht wie erwartet; inzwischen werden solche Listen beim Anlegen automatisch in Einzeleinträge je System aufgeteilt.
Nächtlicher Abgleich und Live-Meldungen
Ein Kalender in einer Datenbank veraltet in dem Moment, in dem jemand per Hand eine Crontab oder einen Timer ändert und den Kalendereintrag vergisst. Deshalb verweist jeder Termin auf seine Quelle im Zielsystem, und ein nächtlicher Abgleichlauf liest die echten Zeitpläne auf den Linux-Systemen, den Hypervisoren, dem Backup-Server, in GitLab und in der Windows-Aufgabenplanung rein lesend aus. Gleich beim ersten Durchlauf fand dieser Abgleich einen vergessenen Eintrag: Ein nächtlicher Synchronisationsjob lief zwar zuverlässig per Cron auf dem Admin-Container, fehlte aber komplett in meiner bisherigen Dokumentation. Der Lauf meldet solche unregistrierten Zeitpläne genauso wie deaktivierte Jobs, verschobene Startzeiten oder den festen UTC-Versatz bei Windows-Aufgaben; lässt sich ein System nachts nicht abfragen, endet der Abgleich mit einem Fehler statt mit einem stillen „ok“.
Selbst ein frisch abgeglichener Zeitplan verrät allerdings nur, wann ein Backup starten soll – nicht, ob es heute nach zwanzig Minuten fertig war oder wegen einer großen virtuellen Maschine noch nach anderthalb Stunden schreibt. Deshalb übermitteln die wichtigen Sicherungs- und Wartungsjobs ihren tatsächlichen Start und ihr Ende direkt an den Kalender; fällt die Verbindung zur Datenbank dabei aus, läuft das Backup vor Ort trotzdem normal durch. Bei Cluster-Backups über mehrere Knoten fasst der Kalender die Teilmeldungen zusammen und gibt das Gesamtfenster erst frei, wenn der letzte Knoten fertig ist. Sobald eine Endmeldung eintrifft, stehen die Systeme sofort wieder für andere Arbeiten bereit, selbst wenn das geplante Fenster noch andauert. Jede Startmeldung bekommt eine Ablauffrist aus dem geplanten spätesten Ende plus einem festen Puffer. Kommt bis dahin keine Endmeldung an – etwa weil ein Prozess hängt oder der Host hart ausgeschaltet wurde –, bleibt die Sperre bestehen, bis ich die Ursache geprüft und die Meldung von Hand geschlossen habe.
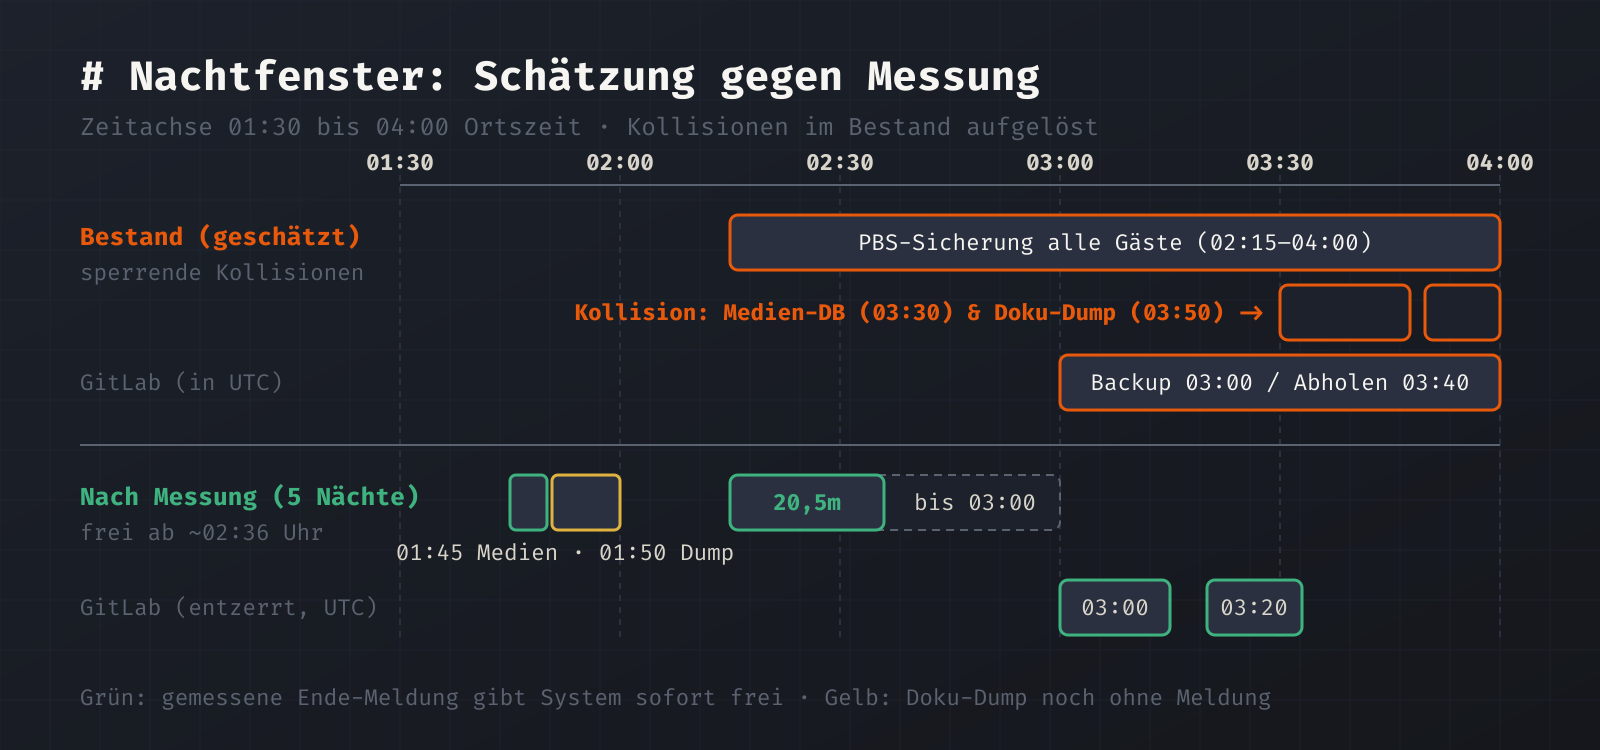
Mit den Start- und Endmeldungen aus fünf Nächten konnte ich die anfangs geschätzten Puffer durch gemessene Laufzeiten ersetzen, die nächtlichen Kollisionen auflösen und gleich in der ersten Nacht einen täglichen Wartungslauf aufspüren, der statt weniger Minuten fast fünf Stunden lang festhing. Wie diese Messreihe im Detail aussah und wie ich den Nachtfahrplan danach umgebaut habe, beschreibe ich in einem eigenen Artikel.
Kopplung an Wartungsskripte und Monitoring
Ein Kalender nützt wenig, wenn sich Skripte und Administratoren im Alltag freiwillig daran erinnern müssen. Meine Wartungsskripte fragen deshalb vor jedem Eingriff automatisch den Kalender ab und prüfen ergänzend, ob auf den Hypervisoren oder dem Backup-Server noch Sicherungsprozesse aktiv sind; ist das Fenster belegt, brechen sie ab oder warten in festen Intervallen auf die Freigabe. Auch vor Neustarts, dem Herunterfahren eines Hosts, dem Stoppen von Gästen oder dem Einspielen von System-Updates steht automatisch diese Kalenderabfrage. Läuft gerade eine Sicherung oder antwortet die Datenbank nicht, wird der Eingriff mit der konkreten Begründung aus dem Kalender abgelehnt.
Für geplante und freigegebene Wartungen, Migrationen sowie aktive Wartungsmodi trägt ein regelmäßiger Abgleich automatisch Wartungszeiten im Monitoring ein und räumt sie wieder ab, falls ein Termin vorab entfällt. In die Gegenrichtung überwacht das Monitoring den Betriebskalender selbst und schlägt Alarm, sobald die Datenbank nicht lesbar ist oder ein laufender Job sein geplantes Ende deutlich überschreitet, ohne eine Endmeldung zu senden.
Was noch offen ist
Das alte starre Sperrfenster von 02:00 bis 04:00 Uhr läuft während der ersten Woche noch als Rückfallebene mit, bis die Live-Meldungen sieben Nächte am Stück ohne Aussetzer durchgelaufen sind. Danach stehen noch die Start- und Endmeldung für den nächtlichen Dump der Dokumentationsdatenbank, die Laufzeitmessung der monatlichen Backup-Verifikation am Monatsersten und die Umstellung der letzten UTC-Crontabs auf Europe/Berlin an.
Schreibe einen Kommentar