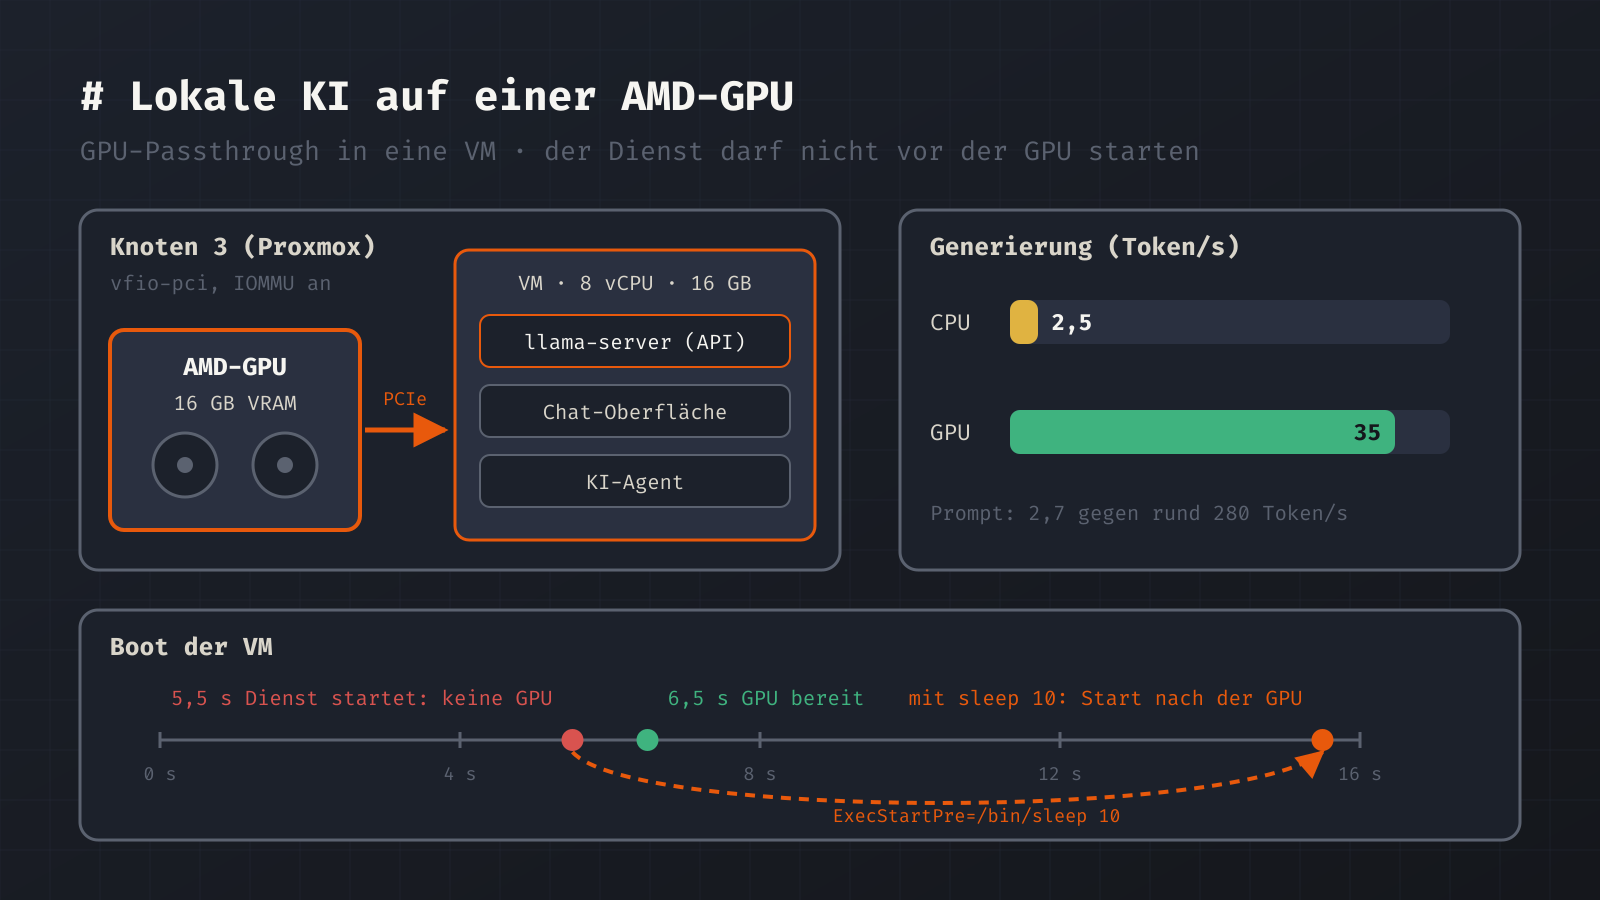
Ein Sprachmodell zu Hause betreiben, ohne dass Anfragen das Haus verlassen: Das war der Plan für eine AMD-Grafikkarte, die ich ohnehin noch hatte. Sie steckt in Knoten 3 meines Proxmox-Clusters und wird per PCIe-Passthrough an eine VM durchgereicht. Darin läuft llama.cpp mit einer OpenAI-kompatiblen Schnittstelle. Das Modell antwortet auf der GPU mit über 35 Token pro Sekunde. Allerdings lief es rund zehn Tage lang unbemerkt auf der CPU, mit 2,5 Token pro Sekunde. Und der Host ist seit einem Proxmox-Upgrade zweimal hart abgestürzt. Die Ursache dafür kenne ich noch nicht.
Der Aufbau
Die Karte ist eine Radeon RX 6800 XT mit 16 GB VRAM (Navi 21, gfx1030). Die VM hat 8 vCPU vom Typ host, 16 GB RAM, eine 200-GB-Platte auf der NVMe des Knotens, UEFI (OVMF) und den Gast-Agenten. Als Betriebssystem dient Ubuntu mit dem Treiber amdgpu und ROCm. Darauf laufen vier Dinge. Der llama-server aus llama.cpp ist selbst mit ROCm gebaut und läuft als systemd-Dienst. Er stellt das Modell über eine OpenAI-kompatible API bereit. Open WebUI dient als Chat-Oberfläche in Docker und spricht ihn über host.docker.internal an. Ein KI-Agent in einem zweiten Container nutzt dieselbe API. Mit einer kleinen Weboberfläche schalte ich die Dienste und wechsle zwischen drei Modellprofilen.
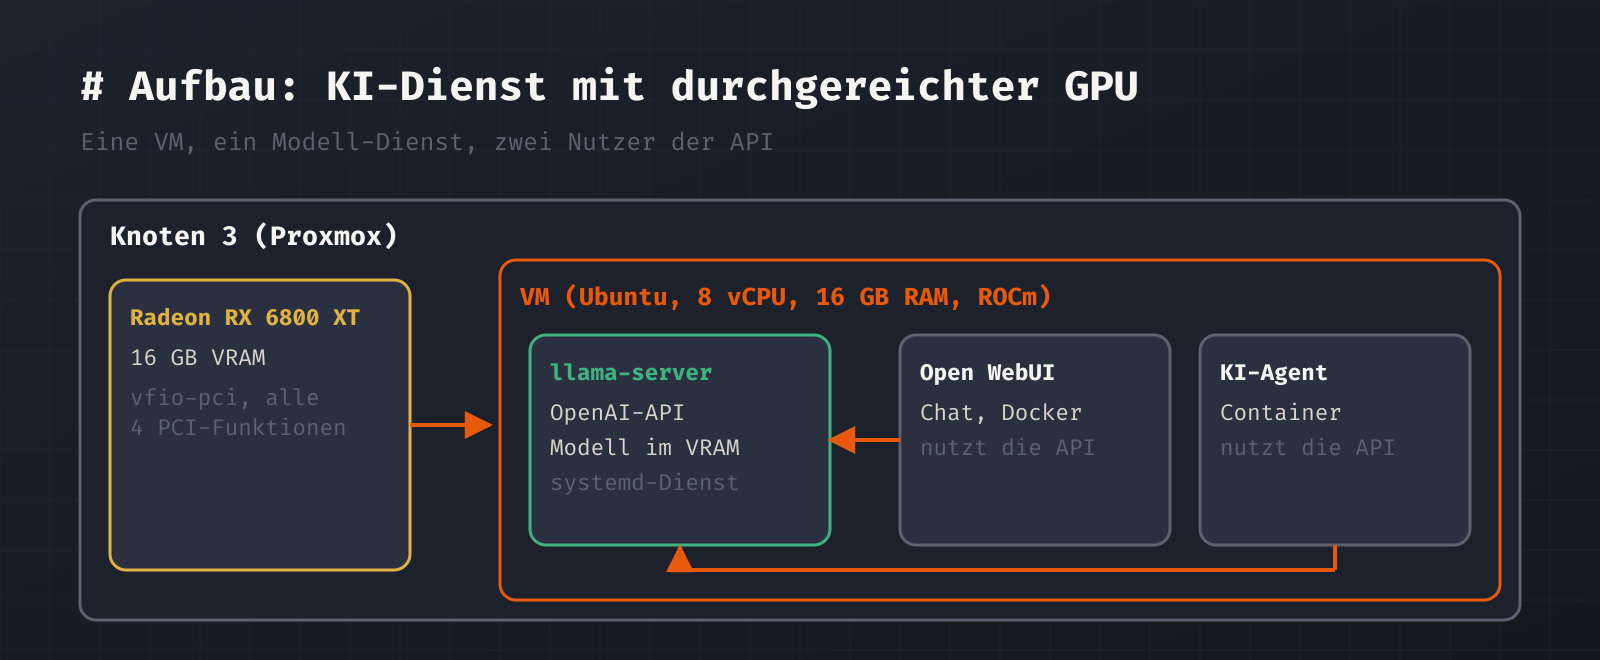
Anfangs hatte die VM 32 GB RAM. Im Betrieb waren aber nur rund 2 GB belegt, dazu kamen etwa 8,6 GB Cache für die per mmap geladene Modelldatei. 16 GB reichen deshalb. Der Grund ist einfach: Mit -ngl 99 liegen alle Schichten des Modells im VRAM, nicht im Arbeitsspeicher der VM.
GPU-Passthrough auf dem Host
Auf dem Knoten sind IOMMU und der Treiber vfio-pci per Kernel-Parameter eingeschaltet. Wichtig: Eine moderne Grafikkarte hat mehrere PCI-Funktionen. Neben der Grafik sind das bei dieser Karte Audio und zwei weitere Funktionen. Alle vier IDs gehören in vfio-pci.ids, damit der Host keine davon für sich beansprucht.
# /etc/default/grub auf dem Knoten mit der Karte (Intel-CPU)
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt vfio-pci.ids=1002:73bf,1002:ab28,1002:73a6,1002:73a4"
# danach: update-grub und Neustart
Im Gast setze ich zusätzlich HSA_OVERRIDE_GFX_VERSION=10.3.0 für ROCm. Die VM nutzt den Maschinentyp q35 und bekommt die ganze Karte durchgereicht, also alle Funktionen unter ihrer PCI-Adresse. Damit ist die VM an diesen einen Knoten gebunden. Eine Migration auf einen anderen Knoten geht nicht.
Beim Start der VM meldet Proxmox failed to reset PCI device … Inappropriate ioctl. Die Karte beherrscht keinen Funktions-Reset. Die VM startet trotzdem, und die Dienste laufen. Ich habe mir aber notiert: Hängt die VM einmal nach einem Neustart aus dem Gast heraus, ist das die erste Spur. Ein vollständiges Stoppen und Starten ist dann der sicherere Weg.
Die Falle: Der Dienst ist schneller als die GPU
Dieser Fehler hat mich am meisten geärgert. Bei jedem Boot der VM startet llama-server etwa eine Sekunde, bevor die GPU bereit ist. Im Journal sieht das so aus: Bei 5,5 Sekunden meldet der Treiber no gpu node! Cannot create KFD process, bei 6,5 Sekunden ist die Karte initialisiert. llama-server findet in diesem Moment kein Gerät, schreibt no usable GPU found ins Log und läuft weiter, nur eben auf der CPU. Es gibt keinen Fehler, keinen Absturz und keinen Neustart des Dienstes.
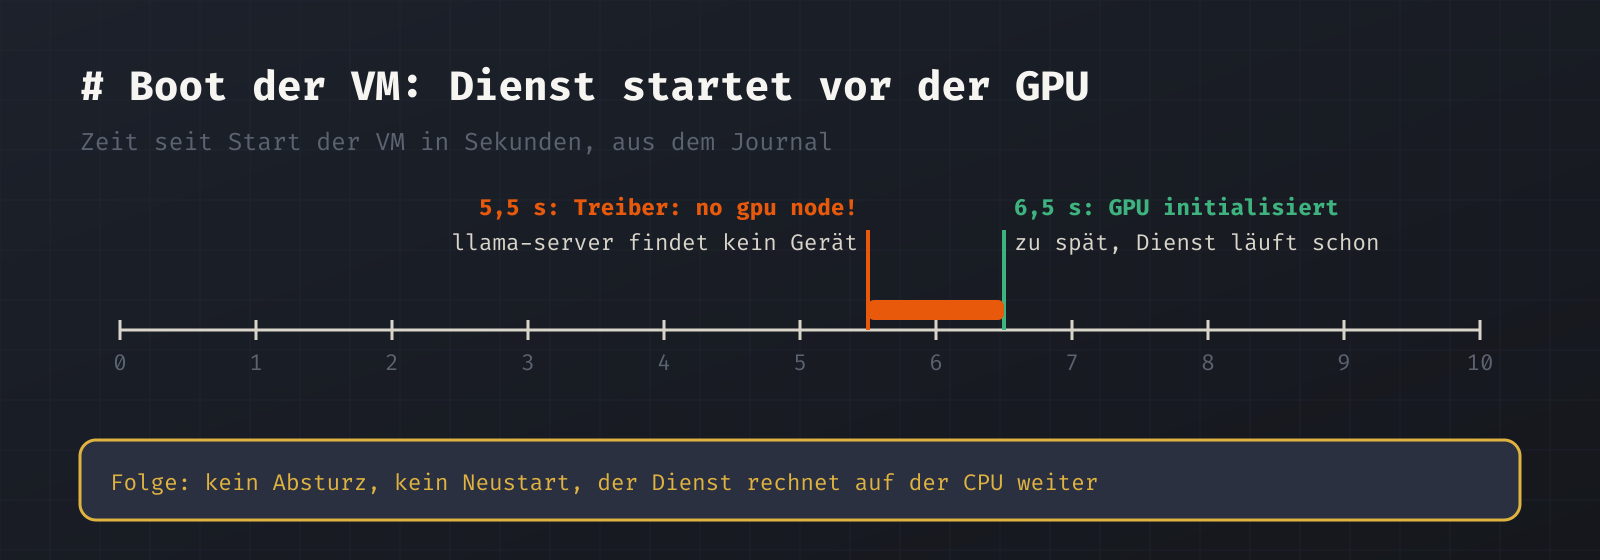
Aufgefallen ist mir das erst nach rund zehn Tagen, bei einer Messung der Geschwindigkeit. Die acht vCPUs liefen dauerhaft bei 100 Prozent, die GPU stand bei 0 Prozent und 6 Watt. Startete ich den Dienst nach dem Boot von Hand neu, fand er die Karte sofort, und das VRAM war zu 82 Prozent belegt. Das Problem tritt erst seit dem Upgrade des Knotens von Proxmox 8.4 auf 9.2 auf. Vorher hat die damals genutzte Laufzeitumgebung die GPU beim Boot gefunden.
Meine Abhilfe ist eine Wartezeit vor dem Start, als Drop-in für den Dienst.
# /etc/systemd/system/<dienst>.service.d/gpu-delay.conf
[Service]
ExecStartPre=/bin/sleep 10

# danach
systemctl daemon-reload
Das wirkt, ist aber eine Krücke. Sauberer wäre eine Prüfung, ob die GPU da ist, etwa mit llama-server --list-devices, und ein Abbruch, wenn nicht. Dann würde systemd den Dienst erneut starten, statt ihn stillschweigend auf der CPU laufen zu lassen. Das steht noch aus, weil ich zuerst die Abstürze klären will. Den Maschinentyp der VM habe ich testweise auf den älteren Stand pc-q35-9.2 festgesetzt. Am Wettlauf hat das nichts geändert.
CPU gegen GPU: die Zahlen
Das Standardmodell ist ein stark quantisiertes Modell mit 27 Milliarden Parametern, die Datei ist nur 5,9 GB groß. Gemessen habe ich mit dem Kontext von 65.536 Token, den mein Agent braucht:
| Messung | CPU (8 vCPU) | GPU (RX 6800 XT) |
|---|---|---|
| Generierung | 2,3 bis 2,5 Token/s | 35 Token/s (Prompt mit 3.200 Token), 26,6 Token/s (Prompt mit 12.400 Token) |
| Prompt verarbeiten | 2,7 Token/s | 271 bis 286 Token/s |
| Auslastung | 8 vCPU bei 100 % | VRAM 13,8 GB, unter Last bis 16,8 GB |
Bei der Generierung ist die GPU also rund 15-mal so schnell, beim Einlesen des Prompts rund 100-mal. Das Einlesen fällt stärker ins Gewicht: Ein Agent schickt bei jeder Anfrage einen langen Systemprompt mit. Auf der CPU wartest du bei einigen tausend Token mehrere Minuten, bevor überhaupt das erste Wort kommt.
Über die Weboberfläche wechsle ich zwischen drei Profilen. Ein Wechsel dauert 6 bis 9 Sekunden:
| Profil | Datei | Kontext | Ergebnis |
|---|---|---|---|
| 27B, stark quantisiert (Standard) | 5,9 GB | 65.536 | 39 Token/s, langer Agenten-Prompt passt |
| 12B, Q5_K_M | 8,7 GB | 16.384 | 37 Token/s, Agenten-Prompt passt nicht |
| 27B, Q3_K_XL | 13,4 GB | 8.192 | 25 Token/s, Agenten-Prompt passt nicht |
Für neue Profile gilt: Der Dienst startet das Modell immer unter demselben Alias. Agent und Chat-Oberfläche zeigen auf diesen Alias und merken vom Wechsel nichts.
Flash Attention: abgestürzt statt schneller
Das VRAM ist mit 16,8 GB unter Last randvoll. Flash Attention hätte geholfen: Mit -fa on sank die Belegung auf 10,6 GB. Allerdings brach der Server bei der ersten Anfrage ab (Exit 134). Er stirbt im Flash-Attention-Kern des HIP-Builds für diese GPU-Generation, und zwar bei der Kopfgröße 256, die das Modell nutzt. Ich bin auf -fa 0 zurückgegangen. Damit fallen auch alle Optionen weg, die Flash Attention voraussetzen, etwa ein quantisierter V-Cache. Etwa 6 GB des VRAM gehen ohne Flash Attention auf den Rechenpuffer. Bei einer RDNA2-Karte prüfe ich diese Option deshalb mit einer echten Anfrage und nicht nur mit dem Start des Servers.
Stabilität: zwei harte Abstürze, Ursache offen
Der Knoten mit der Karte ist innerhalb von drei Tagen zweimal hart abgestürzt. Alle VMs und Container auf ihm waren weg, der Autostart hat sie danach zurückgebracht. Beim ersten Mal lief das Modell auf der CPU, beim zweiten Mal zwei Minuten nachdem ich den Dienst mit GPU neu gestartet hatte.
Die Spurensuche war mager. Im Kernel-Log steht kein Hardwarefehler (kein MCE, kein AER, nichts von amdgpu), pstore ist leer, und beide Boots endeten ohne Shutdown-Eintrag. Gemeinsam haben beide Fälle eine hohe Dauerlast der VM und das Upgrade einige Tage zuvor: Proxmox 8.4 auf 9.2, Kernel 6.8 auf 7.0, QEMU 9.2 auf 11.0. Vor dem Upgrade gab es keine solchen Resets. Der Knoten hat keine Fernwartungsschnittstelle wie IPMI, und den BIOS-Stand habe ich noch nicht geprüft.
Der Zusammenhang mit der GPU ist ein Indiz, kein Beweis. Im nächsten Wartungsfenster setze ich den älteren Kernel 6.8 auf dem Knoten fest und beobachte ihn. Dazu kommen BIOS-Stand, Microcode und Netzteil. Bis dahin setze ich die GPU nicht unter Dauerlast. Einzelne Tests, etwa fünf Modellwechsel und die Messreihe oben, liefen ohne Absturz. Erst nach der Klärung sichere ich den Dienst mit einer Prüfung auf die GPU ab.
Weitere offene Punkte
Die API war anfangs nicht geschützt: Lauscht llama-server auf allen Schnittstellen, kann jedes Gerät im Netz das Modell nutzen. Das Binden an 127.0.0.1 hätte die Chat-Oberfläche im Docker-Container ausgesperrt, deshalb läuft der Server jetzt mit --api-key, und die Oberfläche schickt den Schlüssel mit.
Das Modell gibt es nur einmal. Die VM steckt im täglichen Backup-Job, die Modelldatei, die Daten des Agenten und das Volume der Chat-Oberfläche sind aber nicht einzeln gesichert. Vor jedem Aufräumen kommt deshalb erst eine Kopie des Modells auf eine andere Platte. Rund 30 GB Modelle einer früheren Laufzeitumgebung liegen noch auf der Platte, obwohl der Dienst abgeschaltet ist.
Die Buttons der Weboberfläche ließen sich im Browser nicht anklicken, obwohl alle Tests mit curl grün waren. Die Sicherheitsrichtlinie (CSP) blockierte die Inline-Handler onclick=. Geholfen hat Ereignis-Delegation in einer eigenen JavaScript-Datei. Seitdem teste ich solche Oberflächen in einem echten Headless-Browser.
Als Nächstes kommt der Kernel 6.8. Läuft der Knoten damit unter Last stabil, liegt es am Upgrade und nicht an der Karte.
Schreibe einen Kommentar