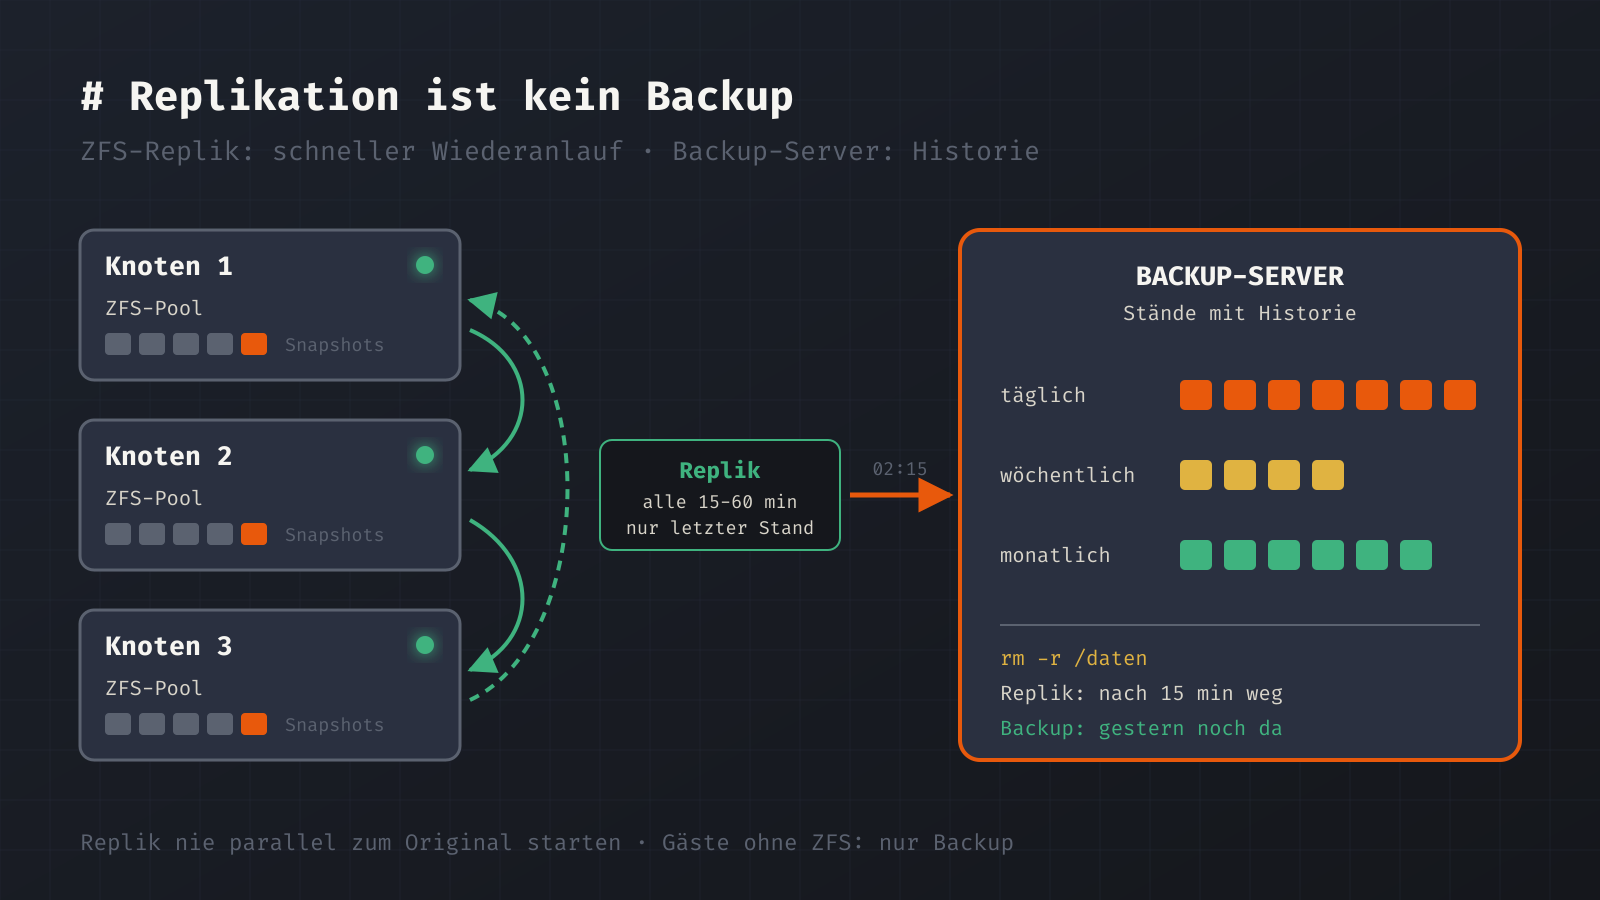
Mein Proxmox-Cluster repliziert die wichtigsten Gäste zwischen den drei Knoten, manche alle 15 Minuten. Fällt ein Knoten aus, liegt auf einem anderen eine fast aktuelle Kopie der Platten. Eine Replik ist aber kein Backup: Sie überbrückt den Ausfall eines Rechners, übernimmt jedoch jeden logischen Fehler auf den Platten. Deshalb laufen bei mir ZFS-Replikation und der Proxmox Backup Server nebeneinander.
Warum ZFS
Jeder meiner drei Knoten hat einen ZFS-Pool mit rund 800 GB auf der SATA-SSD, überall unter demselben Namen. Ausschlaggebend war für mich vor allem ein Punkt: Die eingebaute Replikation von Proxmox (pvesr) arbeitet ausschließlich mit ZFS-Volumes. Ein Gast auf LVM-Thin lässt sich sichern, aber nicht replizieren. Als ich entschieden habe, wo mein GitLab liegen soll, fiel die Wahl deshalb auf ZFS statt auf die schnellere NVMe, damit eine Kopie auf einem anderen Knoten liegt.
ZFS schreibt geänderte Blöcke an eine neue Stelle, sodass ein Snapshot nur die alten Blöcke festhält und fast nichts kostet. Darauf baut die Replikation auf: Nach dem ersten vollen Abgleich überträgt sie nur noch die Änderungen seit dem letzten Snapshot. Nebenbei prüft ZFS beim Lesen über Prüfsummen für jeden Block, ob die Daten noch stimmen. Ein monatlicher Scrub liest den ganzen Pool; bei mir laufen die Scrubs in sechs bis zwölf Minuten durch und melden null Fehler. Außerdem ist die Kompression aktiv und erreicht je nach Knoten ein Verhältnis von 1,21 bis 1,40 zu 1. Das macht sich besonders bei wachsenden Logdateien bemerkbar, etwa beim Abfrageprotokoll meines DNS-Filters.
Dieses Setup hat bei mir aber auch Grenzen. Jeder Pool liegt auf einer einzigen SSD. Die Prüfsummen erkennen zwar kaputte Blöcke, können sie ohne zweite Kopie aber nicht reparieren. Zudem braucht der ZFS-Cache Arbeitsspeicher. Auf meinem großen Knoten habe ich ihn auf 4 GB begrenzt, weil er sonst mit den Gästen um RAM konkurrierte.
So ist die Replikation eingerichtet
Neun Gäste werden repliziert, jeweils auf einen anderen Knoten. Die Takte richten sich danach, wie viel Datenverlust ich bei einem Ausfall in Kauf nehme. Früher liefen einige Jobs nur montags bis freitags um Mitternacht – nach einem Ausfall am Sonntag wäre der Stand drei Tage alt gewesen. Heute laufen alle mindestens stündlich:
| Gast | Richtung | Takt |
|---|---|---|
| Firewall (VM) | Knoten 2 → 1 | alle 15 Minuten |
| Monitoring und Doku | Knoten 1 → 3 | alle 30 Minuten |
| Home Assistant | Knoten 3 → 1 | alle 30 Minuten |
| GitLab | Knoten 3 → 1 | alle 30 Minuten |
| zwei Domänencontroller | Knoten 1 und 2 → 3 | stündlich |
| zwei DNS-Filter | Knoten 2 → 3, Knoten 3 → 2 | stündlich |
| Verwaltungscontainer | Knoten 1 → 3 | stündlich |
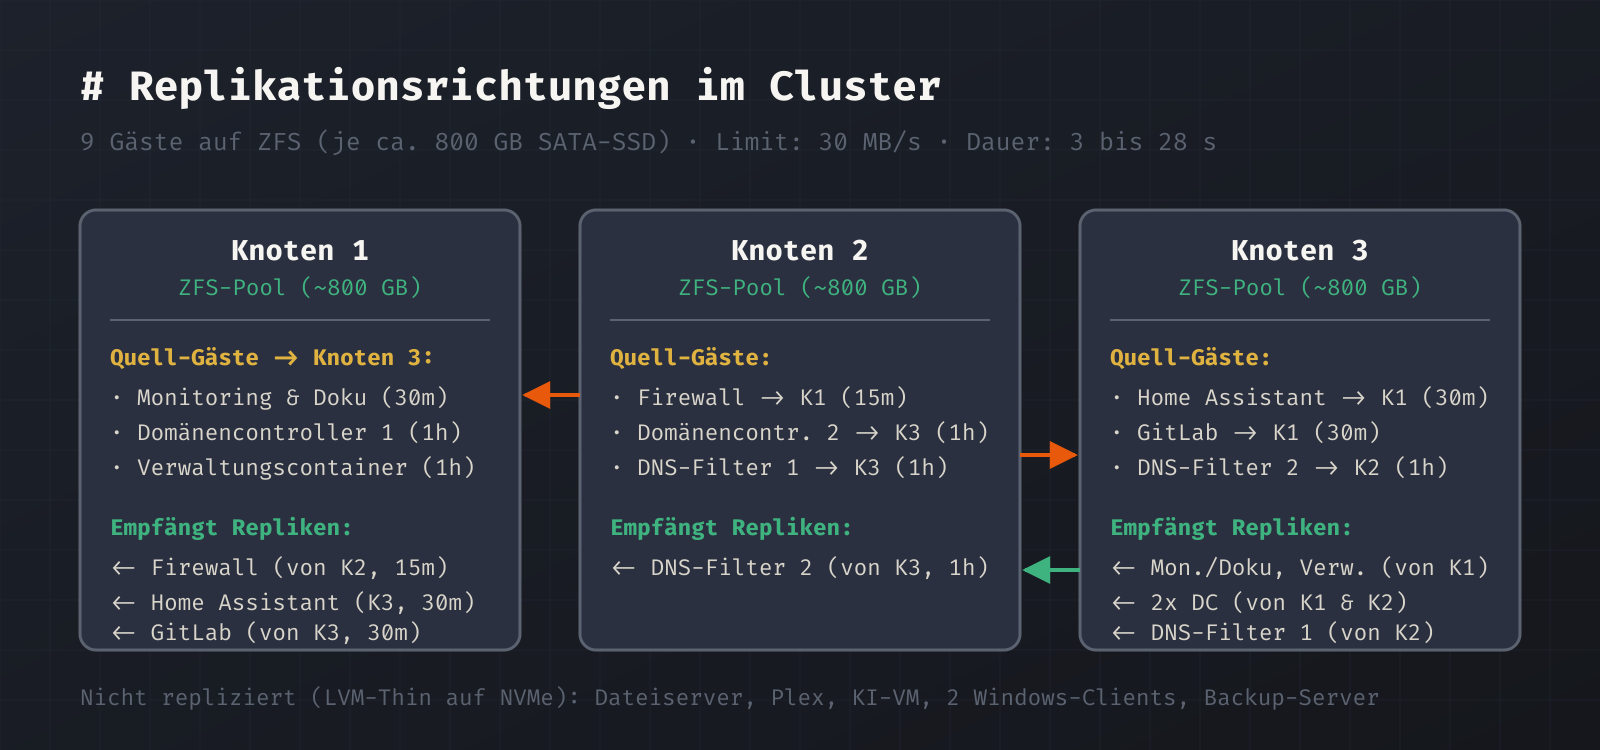
Alle Jobs sind auf 30 MB/s begrenzt. Meine Knoten hängen über USB-Netzwerkadapter am Netz, und die vertragen keine Dauerlast. Die Läufe dauern trotzdem nur 3 bis 28 Sekunden, weil nach dem ersten Abgleich nur noch die geänderten Blöcke übertragen werden. Vor dem Anlegen der Jobs habe ich den Platz auf dem Ziel nachgerechnet: Der ZFS-Speicher ist ohne Thin Provisioning angelegt (sparse 0), eine VM-Platte reserviert dort also ihre volle Größe. Container belegen nur, was tatsächlich geschrieben ist.
# Job anlegen: Gast 109 alle 30 Minuten auf Knoten 1, max. 30 MB/s
pvesr create-local-job 109-0 knoten1 --schedule '*/30' --rate 30

# Zustand prüfen: LastSync, Duration, FailCount, State
pvesr status
Damit ich nicht selbst nachsehen muss, läuft auf jedem Knoten ein lokaler Check für das Monitoring. Er meldet das Alter der letzten Synchronisation, den Fehlerzähler und den Fehlertext für alle neun Dienste.
Was die Replikation leistet
Wenn ein Knoten ausfällt, liegt die Platte des Gastes schon auf einem anderen Knoten, höchstens so alt wie der eingestellte Takt. Ich muss nichts zurückspielen und keine 80 GB über das Netz kopieren. Es reicht, die Konfiguration zu verschieben und den Gast zu starten.
Wie viel Zeit das spart, hat sich bei einem geplanten Umzug gezeigt: Mein Monitoring sollte vom großen Knoten auf einen kleinen wandern. Weil die Replik schon dort lag, dauerte die eigentliche Migration 17 Sekunden. Der gesamte Ausfall lag bei etwa drei Minuten. Danach habe ich die Richtung der Replikation umgedreht.
Bei einem ausgefallenen Knoten übernehme ich einen Gast von Hand, solange die beiden anderen Knoten noch das Quorum haben:
# 1. Sicherstellen, dass das Original wirklich aus ist
# 2. Konfiguration auf den Zielknoten verschieben
#    VM:        mv /etc/pve/nodes/<quelle>/qemu-server/<id>.conf /etc/pve/nodes/<ziel>/qemu-server/
#    Container: mv /etc/pve/nodes/<quelle>/lxc/<id>.conf /etc/pve/nodes/<ziel>/lxc/
# 3. Auf dem Zielknoten starten
qm start <id>     # VM
pct start <id>    # Container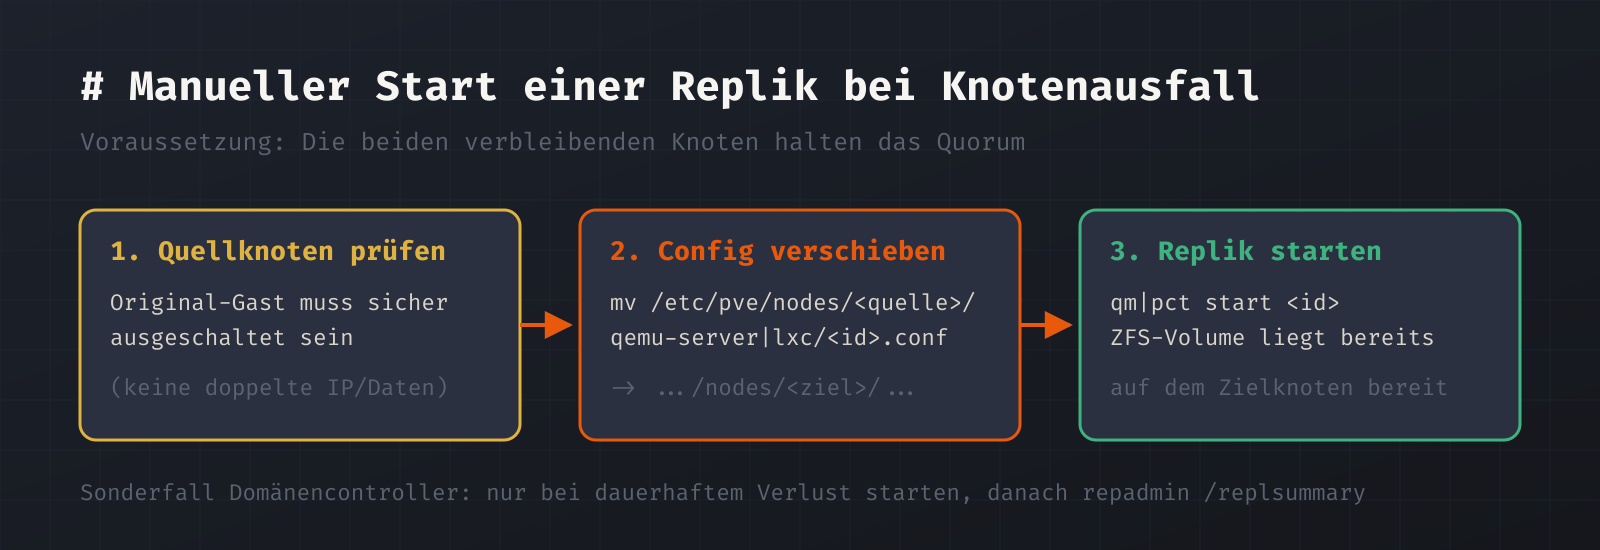
Vor dem Start der Replik muss das Original sicher ausgeschaltet sein. Laufen beide gleichzeitig, gibt es im Netz zwei Maschinen mit gleicher Adresse und gleichen Daten, die ab diesem Moment auseinanderlaufen. Nach der Reparatur des Quellknotens wird die Replikation umgedreht oder neu angelegt und der Gast zurückgezogen.
Ein Sonderfall sind die beiden Domänencontroller. Ihre Replik starte ich nur, wenn das Original dauerhaft verloren ist. Die VM-Generation-ID ist gesetzt, damit der gestartete Domänencontroller sich selbst als wiederhergestellt erkennt. Direkt danach prüfe ich die Active-Directory-Replikation mit repadmin /replsummary.
Was sie nicht leistet
Die Replik ist eine zeitversetzte Kopie des Originals. Alles, was im Dateisystem des Gastes passiert, landet beim nächsten Lauf genauso auf dem Zielknoten:
- Ein versehentlich gelöschter Ordner ist nach spätestens 15 bis 60 Minuten auch in der Replik verschwunden.
- Verschlüsselt ein Trojaner die Daten, überträgt der nächste Job die verschlüsselten Blöcke auf den zweiten Knoten.
- Schlägt ein Update fehl, liegt anschließend auch in der Replik die kaputte Version.
- Es gibt keine Historie und damit keinen Weg zurück zum Stand von gestern oder von letzter Woche.
Dazu kommt: Ohne eingerichtete Hochverfügbarkeit startet die Replik nicht von allein. Außerdem steht der Zielknoten im selben Haus, hängt am selben Notstrom und im selben Netz wie das Original. Gegen Überspannung, Brand oder Diebstahl hilft die Replikation nicht, und eine Kopie außer Haus fehlt mir derzeit noch.
Zusammen mit dem Backup-Server
Der Proxmox Backup Server sichert bei mir jede Nacht um 02:15 Uhr alle Gäste und hält sieben tägliche, vier wöchentliche und sechs monatliche Stände vor. Beide Verfahren decken unterschiedliche Ausfälle ab:
| ZFS-Replikation | Backup-Server | |
|---|---|---|
| Stand | 15 bis 60 Minuten alt | bis zu 24 Stunden alt |
| Historie | nur der letzte Stand | Tage, Wochen, Monate |
| Wiederanlauf | Minuten, ohne Kopieren | Restore über das Netz |
| schützt vor | Ausfall eines Knotens | Löschen, Verschlüsseln, kaputten Updates |
| Speicher | nur ZFS | jeder Speicher |
Der Backup-Server fängt auch die Gäste auf, bei denen ZFS fehlt. Auf meinem großen Knoten liegen der Dateiserver, Plex, die KI-VM, zwei Windows-Clients und der Backup-Server selbst auf einer NVMe mit LVM-Thin. Für diese Gäste gibt es keine Replikation, sondern nur die nächtliche Sicherung. Geplant ist eine zweite NVMe als ZFS-Spiegel, damit sich auch diese Maschinen replizieren lassen.
Prüfliste für die eigene Einrichtung
- Liegen alle Gäste, die repliziert werden sollen, auf einem ZFS-Pool und reicht der Platz auf dem Zielknoten für die volle Plattengröße?
- Passt der Takt – auch am Wochenende – zu dem Datenverlust, der im Ernstfall vertretbar ist?
- Überwacht das Monitoring das Alter der letzten Synchronisation und den Fehlerzähler von
pvesr status? - Sichert ein unabhängiges Backup mit Historie zusätzlich alle replizierten und nicht replizierten Gäste?
- Sind die Befehle für den manuellen Start einer Replik dokumentiert und einmal getestet?
Den letzten Punkt habe ich selbst noch vor mir: Den Start aus einer Replik nach einem echten Ausfall habe ich bisher nicht geübt. Als erster Test ist einer der beiden DNS-Filter in einem Wartungsfenster eingeplant, weil sein kurzer Ausfall im Netz am wenigsten stört.
Schreibe einen Kommentar