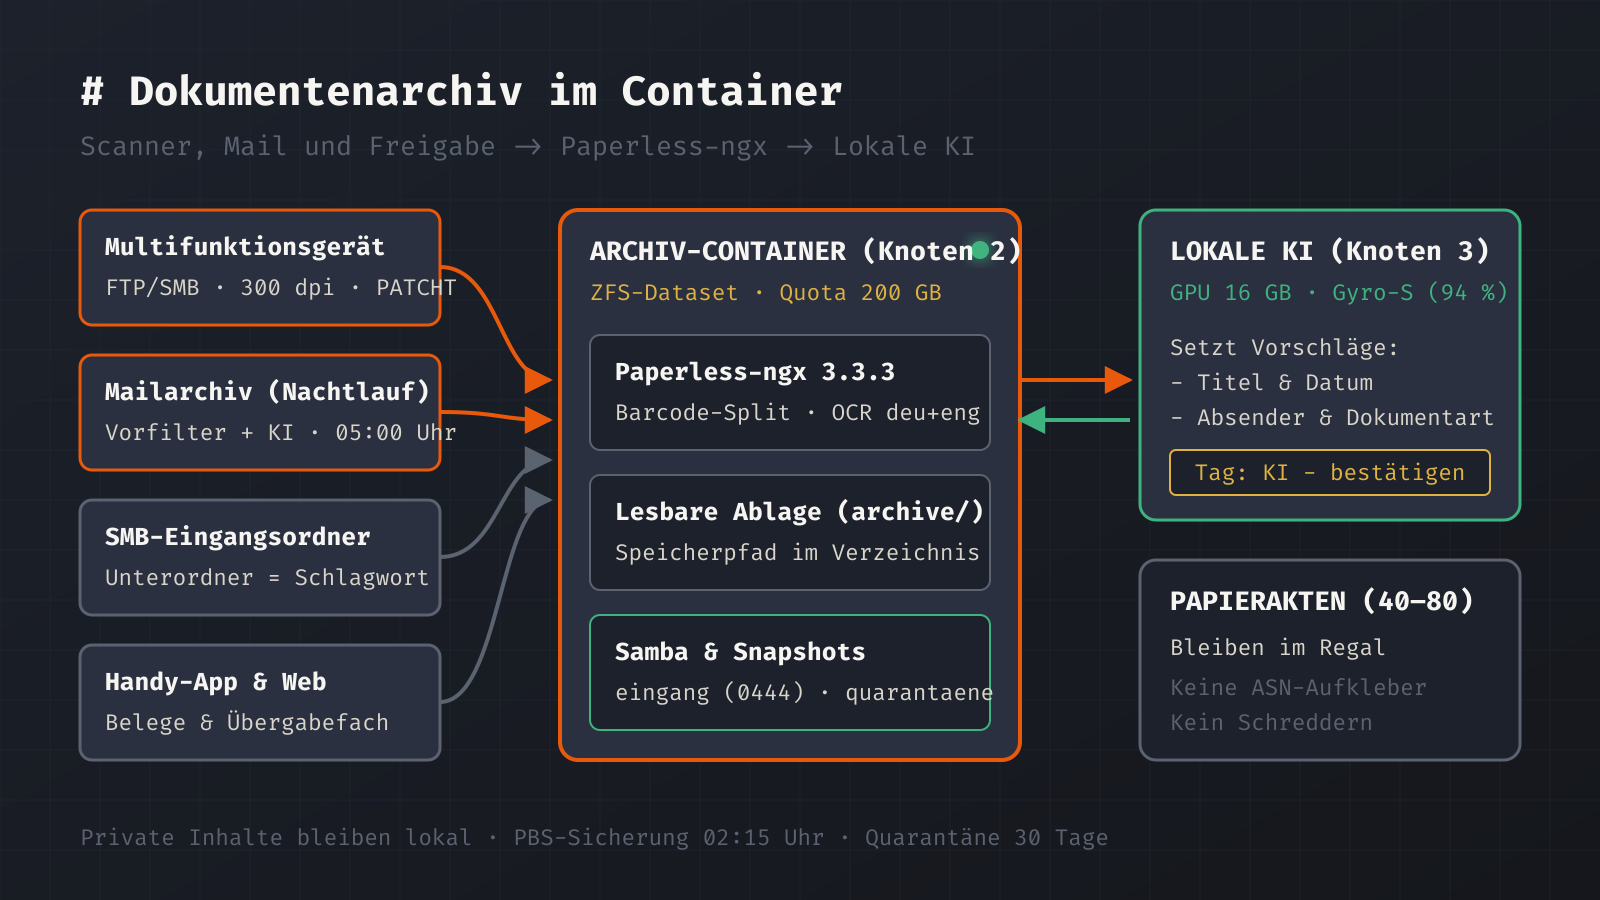
Im Regal stehen zwischen 40 und 80 Aktenordner, auf den Rechnern liegen PDFs aus zehn Jahren, und im Mailarchiv stecken tausende Rechnungen. Ich wollte eine zentrale Volltextsuche über alle Belege, ohne dafür einen neuen Dokumentenscanner zu kaufen oder das Papier im Regal wegzuwerfen. Herausgekommen ist ein Container mit Paperless-ngx auf einem ZFS-Dataset mit 200 GB Quota, der Belege vom alten Multifunktionsgerät, über Netzfreigaben und nachts automatisch aus dem Mailarchiv einsammelt und mit einem lokalen Sprachmodell vorverschlagwortet.
Was ich vor der Installation entschieden habe
Im ersten Entwurf für das Projekt standen die üblichen Empfehlungen aus Foren: ein neuer Duplex-Dokumentenscanner, fortlaufende Archiv-Seriennummern (ASN-Aufkleber) auf jedem Blatt und ein Karton zum Schreddern. Als ich mir den Aufwand im Alltag durchgerechnet habe, ist davon wenig übrig geblieben.
| Frage | Erster Entwurf | Entscheidung für den Betrieb |
|---|---|---|
| Papierakten (40–80 Ordner) | ASN-Etiketten kleben, Rest schreddern | Ordner bleiben nach Thema im Regal, keine Aufkleber, kein Schreddern |
| Hardware zum Scannen | Neuen Duplex-Dokumentenscanner kaufen | Vorhandenes Brother MFC-J5910DW nutzen (Farbe, 300 dpi, per FTP/SMB) |
| Reihenfolge | Alles auf einmal digitalisieren | Neue Post sofort (erst scannen, dann abheften), Altbestand in Etappen nach Nutzen |
Die wichtigste Festlegung betrifft das Papier selbst: Das digitale Archiv dient als Sicherung und für die Volltextsuche von unterwegs, ersetzt aber nicht die Aktenordner. Urkunden bleiben ohnehin im Original. Weil ich keine ASN-Nummern klebe, muss ich auch keinen chronologischen Stapel führen, sondern hefte neue Briefe nach dem Scannen wie gewohnt thematisch ab.
Auch bei der Ordnerstruktur auf dem Dateiserver wollte ich mich nicht von einer einzelnen Software abhängig machen. Alle Daten im Homelab ziehen in einen gemeinsamen DFS-Namensraum (\\example.lan\Daten) mit drei festen Ebenen um. Die oberste Ebene trennt nach Personen sowie einem gemeinsamen Zweig Familie (darunter Finanzen, Steuern, Versicherungen, Verträge, Haus, Fahrzeuge, Behörden, Recht). Dateinamen beginnen mit dem Datum nach dem Muster JJJJ-MM-TT_Thema. Paperless legt seine lesbare archive/-Ablage über Speicherpfade in denselben Baum. Falls der Container eines Tages wegfällt, liegen dort normale PDF-Dateien in sprechenden Ordnern.
Archiv-Container mit ZFS-Quota auf Knoten 2
Der Proxmox-Cluster besteht aktuell aus drei Knoten mit je einem rund 800 GB großen ZFS-Pool. Knoten 1 war zu 76 Prozent belegt, Knoten 3 zu 86 Prozent, nur Knoten 2 hatte mit 43 Prozent Belegung noch 436 GB frei. Ein größerer Dateiserver mit zusätzlichen NVMe-SSDs und einem Festplatten-Pool ist im Bau, aber ich wollte mit den Dokumenten nicht warten, bis die neue Hardware fertig eingerichtet ist.
Deshalb läuft der Archiv-Container (Debian-LXC, IP 192.0.2.29) auf Knoten 2. Seine Datenplatte liegt als eigenes ZFS-Dataset unter /srv/archiv und ist mit einer Quota von 200 GB begrenzt. Das hält den ZFS-Pool auch dann unter der kritischen 80-Prozent-Marke, wenn beim Einlesen alter Quellen größere Datenmengen anfallen. Die Quota erhöhe ich erst, wenn das Größenregister aller Datenquellen vollständig ausgefüllt ist. Der Container hängt im nächtlichen Job des Proxmox Backup Servers (02:15 Uhr) und wird mit 16 Diensten in Checkmk überwacht.
Über Samba stellt der Container fünf Freigaben im Netz bereit: eingang, arbeit, quarantaene, dokumente und scan. Für allgemeine Datenbestände gilt beim Einlesen ein fester Ablauf: Kopien landen schreibgeschützt (Rechte 0444) im Eingang und werden dort mit ihrer SHA-256-Prüfsumme protokolliert, danach zieht Knoten 2 einen ZFS-Snapshot. Gelöscht wird erst nach Freigabe über den Ordner quarantaene mit 30 Tagen Frist.
Im Container läuft Paperless-ngx 3.3.3 über Docker Compose mit deutscher und englischer Texterkennung (deu+eng). Die Docker-Abbilder aktualisiere ich nicht automatisch, sondern halte die Version in der Compose-Datei fest. Beim Betrieb im Container sind mir zwei Details aufgefallen:
- Die Variable
PAPERLESS_CONSUMER_IGNORE_PATTERNSerwartet in Paperless 3.x reguläre Ausdrücke. Wer dort klassische Shell-Glob-Muster einträgt, bringt den Eingangswächter zum Absturz. - Wartungsbefehle über
manage.pyim Container dürfen nicht direkt mitpython3aufgerufen werden, weil dann die Umgebungsvariablen fehlen und die Datenbank die Anmeldung ablehnt. Der Aufruf muss über/command/with-contenv python3 manage.py ...laufen.
Eingang über Scanner, Trennblätter und Netzfreigabe
Als Scanner steht hier ein älteres Tintenstrahl-Multifunktionsgerät, ein Brother MFC-J5910DW. Ganze Aktenordner lassen sich damit nur verarbeiten, wenn man nicht jedes zweiseitige Schreiben einzeln am Display starten muss. Die Lösung sind Barcode-Trennblätter.
Ein kleines Python-Skript erzeugt im Paperless-Container (dort sind die nötigen PDF- und Barcode-Bibliotheken bereits vorhanden) ein druckfertiges Trennblatt mit dem Standard-Code128 PATCHT sowie einen erfundenen Teststapel zur Kontrolle. In der Umgebungsdatei von Paperless schaltet man die Trennung frei:
PAPERLESS_CONSUMER_ENABLE_BARCODES=true
PAPERLESS_CONSUMER_BARCODE_STRING=PATCHT
PAPERLESS_CONSUMER_BARCODE_DPI=300
Bei der täglichen Briefpost wird künftig vor jedes mehrseitige Schreiben ein Trennblatt gelegt; der Stapel kommt in den Einzug und wird mit 300 dpi in Farbe per FTP oder SMB in den Eingang gescannt. Paperless schneidet das PDF am Barcode auf und verwirft die Trennseite. Bei den 40 bis 80 alten Aktenordnern ist ein anderer Ablauf geplant: Die Trennblätter kommen nur zwischen die Register eines Ordners, der Einzug läuft durch. Gestartet ist dieser Altbestand noch nicht. Jeder Aktenordner landet in einem eigenen Unterordner von \\archiv.example.lan\scan. Paperless übernimmt den Namen des Unterordners automatisch als Schlagwort.
Für digitale Dokumente, die im Alltag auf den Rechnern oder Handys anfallen, gibt es neben der Smartphone-App und einem Übergabefach im Intranet einen gemeinsamen Ordner Familie\Eingang auf dem Dateiserver. Ein systemd-Timer auf dem Archiv-Container soll neue Dateien dort abholen, an Paperless übergeben und das Original nach Eingang\_Übergeben verschieben. Der Timer ist gebaut und hat seinen Selbsttest bestanden; die Abnahme durch einen echten Test steht noch aus.
Rechnungen aus dem Mailarchiv fischen
Viele Belege kommen gar nicht mehr auf Papier, sondern liegen zwischen zehntausenden Mails im Postfach. Statt Paperless direkt per IMAP auf das produktive Postfach loszulassen, durchsucht ein Python-Skript (nur Standardbibliothek) jede Nacht das lokale Mailarchiv in einem eigenen Container. Der Abgleich der Postfächer läuft um 04:30 Uhr, das Belegskript startet um 05:00 Uhr und liest die Maildirs ausschließlich lesend.
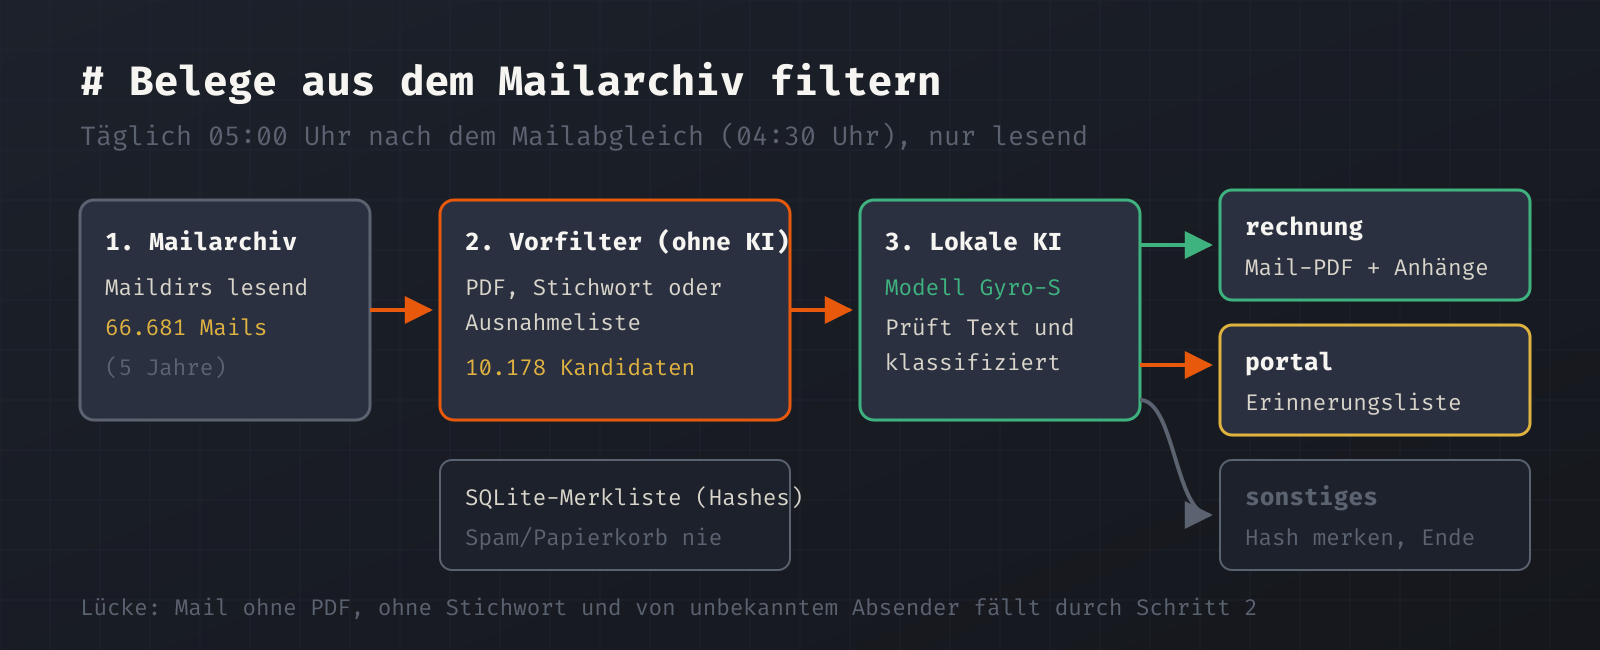
Im Probelauf über den gesamten Bestand lagen dort 154.141 Mails, davon 66.681 aus den letzten fünf Jahren. Jede dieser Nachrichten durch ein Sprachmodell zu schicken, würde Tage dauern. Deshalb arbeitet das Skript zweistufig:
Zuerst sortiert ein Vorfilter ohne KI alle Ordner wie Spam, Newsletter und Papierkorb komplett aus. Eine Mail gilt nur dann als Kandidat, wenn sie einen PDF-Anhang hat, ein typisches Rechnungs-Stichwort enthält oder von einem Absender auf einer lokalen Ausnahmeliste stammt. Eine SQLite-Datenbank speichert die Hashes bereits geprüfter Mails, damit keine Nachricht zweimal untersucht wird. In die Logdateien schreibt das Skript aus Datenschutzgründen nur Anzahlen, keine Betreffzeilen oder Absender.
Im Fünfjahresbestand blieben nach dem Vorfilter 10.178 Kandidaten übrig. Die gehen im zweiten Schritt an die lokale KI, die jede Mail in eine von drei Klassen einteilt: rechnung, portal oder sonstiges. Echte Rechnungen wandelt das Skript samt Mailtext in ein PDF um und legt sie zusammen mit allen Anhängen sowie den Schlagwörtern Beleg-Mail und KI - bestätigen in Paperless ab. Mails vom Typ portal („Ihre Rechnung liegt im Kundenkonto bereit“) landen auf einer Erinnerungsliste.
Aus zwei schon separat sortierten Beleg-Ordnern auf dem Server wanderten beim Start direkt 70 PDFs in Paperless. Für die 10.178 Kandidaten des Altbestands war ursprünglich eine Drossel von 200 Mails pro Nacht geplant, was rund sieben Wochen gedauert hätte. Um den Rückstand schneller abzubauen, lief das Skript einmalig als Dauerlauf ab 05:00 Uhr geschätzt rund 17 Stunden durch (mit hartem Stopp nach 20 Stunden vor dem nächsten Backup-Fenster). Dabei zeigte sich ein Detail von systemd: Bei einem Dienst vom Typ oneshot greift RuntimeMaxSec nicht wie bei einem normalen Daemon, das Zeitlimit muss im Skript oder über den Aufruf abgefangen werden.
Der Vorfilter hat eine bewusste Lücke: Schickt ein kleiner Händler eine reine Textmail ohne PDF-Anhang, ohne klassisches Stichwort wie „Rechnung“ oder „Beleg“ und von einer noch unbekannten Adresse (etwa nur mit dem Betreff „Ihr Einkauf vom 3.10.“), fällt sie durch das Raster. Dagegen hilft im Alltag die Ausnahmeliste für bekannte Absender.
Lokale KI für Ablagevorschläge und der GPU-Absturz
Für das gesamte Projekt gilt die Regel, dass persönliche Dokumente, OCR-Texte und Klartext-Dateinamen das eigene Netz nicht verlassen. Externe Sprachmodelle sehen höchstens anonymisierte Mengenstatistiken, wenn ich Hilfe beim Schreiben von Auswertungsskripten brauche. Die inhaltliche Arbeit erledigt eine virtuelle Maschine auf Knoten 3 mit einer durchgereichten Radeon RX 6800 XT (16 GB VRAM) und 56 GB RAM.
Welches Modell sich am besten für deutsche Belege und Ordnerbäume eignet, habe ich in einem eigenen Vergleich mit 26 lokalen Modellen über einen festen Testkatalog aus erfundenen Dokumenten gemessen. In der Vorrunde lagen Gemma-4-12B (87 Prozent) und Qwen3.8-Flash-Next Gyro-S (86 Prozent) bei den Dokumenten fast gleichauf. In der Hauptrunde mit 128K Kontext und GPU-Bildleser setzte sich Qwen3.8-Flash-Next Gyro-S durch: 94 Prozent Trefferquote bei Dokumenten, 96 Prozent bei Downloads und 98 Prozent bei Ordnerstrukturen.
Gyro-S ordnet die Belege aus dem Mailarchiv ein. Weil auch 94 Prozent im echten Bestand Fehlgriffe bedeuten, bekommt jedes automatisch bearbeitete Dokument zusätzlich das Schlagwort KI - bestätigen. Ich gehe diese Liste am Smartphone oder Rechner durch, prüfe die Felder und entferne das Schlagwort mit einem Klick. Dass Gyro-S auch neue Dokumente direkt in Paperless verschlagwortet, ist entschieden, aber erst für Anfang 2027 geplant. Um später aus meiner lokalen Chat-Oberfläche (Open WebUI) Fragen an den Aktenbestand stellen zu können, gibt es in Paperless ein eigenes reines Lesekonto.
Bei den ersten langen GPU-Testläufen stürzte Knoten 3 um 12:01 Uhr hart ab. Die Ursache war die Stromversorgung: Am Netzteil des Rechners hingen gleichzeitig neun Festplatten. Seit diese Platten an einer externen Versorgung hängen, läuft der Knoten stabil; der Dauerlasttest bleibt im Blick. Aufräum-Aufträge der KI laufen nicht im Backup-Fenster zwischen 02:00 und 04:00 Uhr.
Was noch offen ist
Die Infrastruktur läuft, aber einige Baustellen sind noch nicht abgeschlossen:
- Das lesende Konto sah nach dem ersten großen Import 0 von 913 Belegen in Paperless. Der Grund: Dokumente, denen beim Import ein Eigentümer zugewiesen wird, sind für andere Konten nur sichtbar, wenn die Leserechte explizit geteilt werden. Ein Korrekturskript für die Berechtigungen liegt bereit, muss aber noch über den Bestand laufen.
- Die Anbindung von Open WebUI an Paperless über einen MCP-Server ist geplant und wartet noch auf die korrigierten Leserechte und auf einen Prompt-Injection-Test mit präparierten PDF-Dokumenten aus meinem Testkatalog.
- Am Brother MFC-J5910DW fehlt noch das fest eingespeicherte Scanprofil auf den Schnellwahltasten, und ich muss direkt am Gerät prüfen, ob der Einzug doppelseitige Vorlagen zuverlässig einzieht. Zudem liegen vom ersten Test noch drei künstliche Trennblatt-Dokumente in Paperless, die ich noch löschen muss.
- Für den Zwischenordner
Eingang\_Übergebenauf dem Dateiserver ist die Aufbewahrungsfrist noch nicht endgültig festgelegt; geplant sind 30 Tage analog zur Quarantäne.
Als Nächstes führe ich das Rechteskript für die 913 importierten Belege aus und fülle die Ausnahmeliste auf dem Mailarchiv mit den Absendern, die ihre Rechnungen ohne PDF-Anhang schicken.
Schreibe einen Kommentar