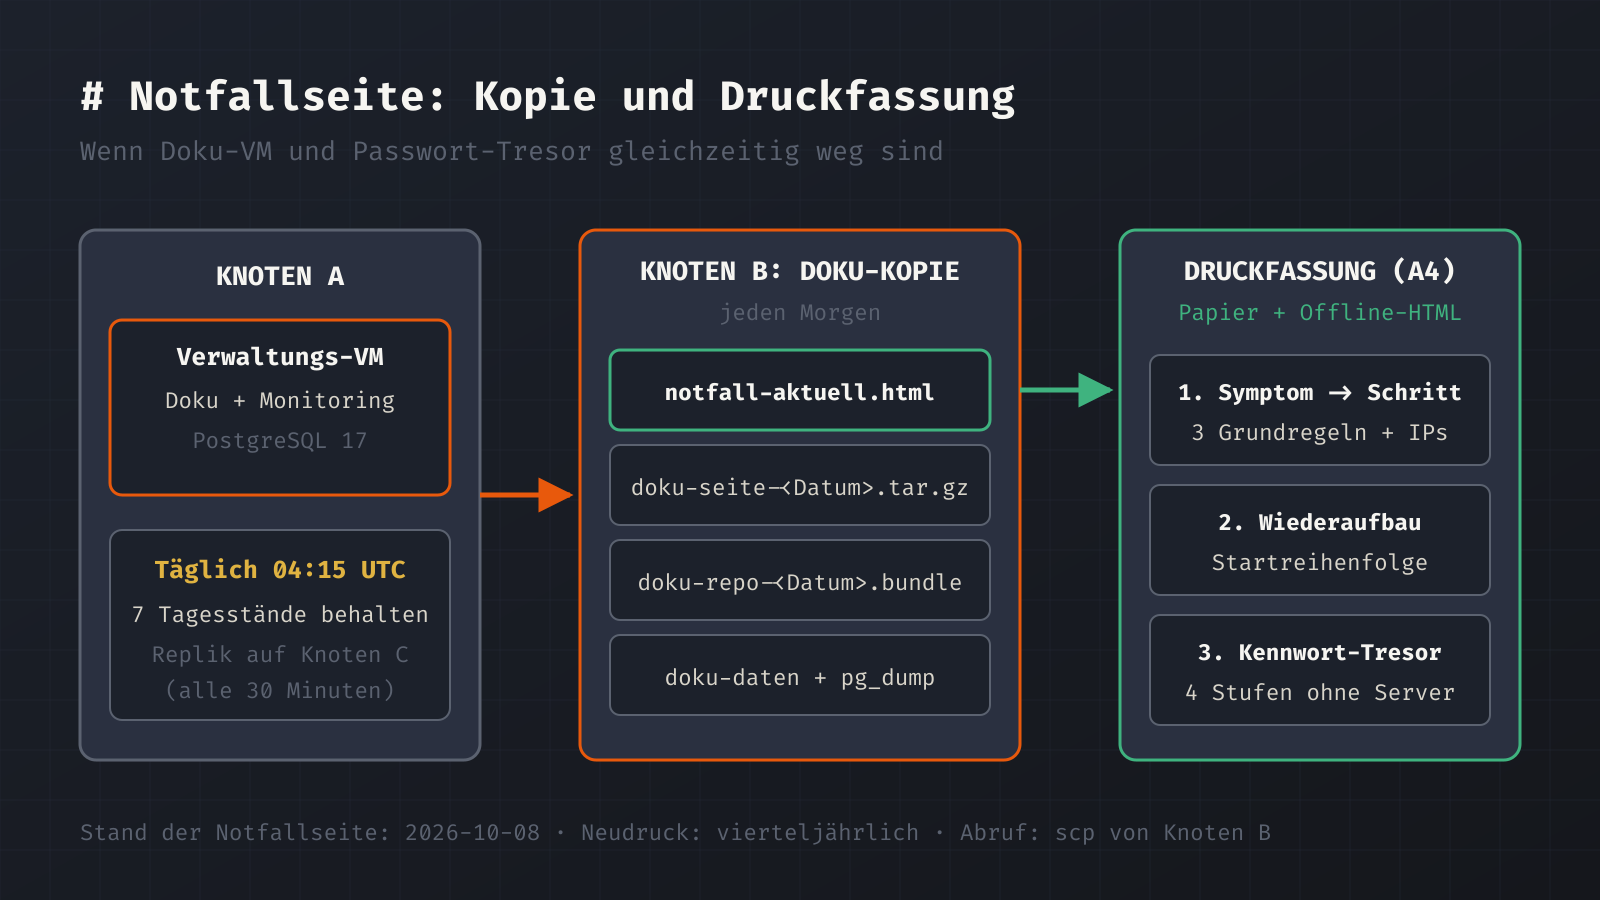
Meine Dokumentation läuft samt Datenbank und Monitoring in einer virtuellen Maschine auf einem der drei Knoten. Fällt dieser Knoten aus oder streikt das Gateway, komme ich im Browser weder an die Runbooks noch an den Passwort-Tresor. Seit dem 8. Oktober 2026 gibt es deshalb eine eigene Einstiegsseite für den Störfall, die am Bildschirm genauso funktioniert wie ausgedruckt auf DIN A4.
Drei Grundregeln vor dem ersten Befehl
Wer nachts vor einem stehenden Dienst sitzt, tippt schnell einen Neustart-Befehl ein und verschlimmert damit die Lage. Ganz oben auf der Notfallseite stehen deshalb drei feste Verbote, noch vor jeder IP-Adresse.
- Nie beide Partner eines Paares gleichzeitig anfassen. Das gilt für die beiden Domänencontroller ebenso wie für die zwei AdGuard-Container oder zwei Proxmox-Knoten.
- Einen Domänencontroller niemals per Snapshot zurückrollen. Ein alter Snapshot bringt die Replikation im Active Directory durcheinander; der Rückweg läuft ausschließlich über den dokumentierten Plan für die Domänencontroller.
- Zuerst hinsehen, danach neu starten. Bevor du einem Rechner den Strom wegnimmst oder eine VM hart zurücksetzt, schaust du auf die Konsole und notierst Meldungen und Uhrzeit.
Die dritte Regel hat einen konkreten Anlass aus dem Oktober. Knoten 3 ist am 5. und am 7. Oktober 2026 zweimal hart abgestürzt, während die Ursache noch offen ist. Wer nach dem Einschalten sofort weiterarbeitet, ohne mit journalctl -b -1 -e die letzten Zeilen vor dem Stillstand zu sichern, verliert den einzigen Hinweis auf den Auslöser.
Die wichtigsten Adressen auf einen Blick
Direkt unter den Grundregeln steht eine kurze Tabelle mit rund zehn Systemen: Gateway, die drei Knoten, beide Domänencontroller, beide DNS-Filter, Backup-Server, Home Assistant, die Verwaltungs-VM und der Admin-Container. Je Zeile stehen die IP-Adresse, die Gast-ID und der Knoten, auf dem der Gast läuft. Wenn das DNS steht, helfen Hostnamen nicht weiter, und in der Proxmox-Oberfläche suchst du nach der ID.
Aus der Tabelle liest du sofort ab, was ein Knotenausfall nach sich zieht. Bei mir hängt an einem Knoten das Internet-Gateway zusammen mit einem Domänencontroller und einem DNS-Filter. Fällt der aus, ist das Internet weg, die Anmeldung läuft aber über den zweiten Domänencontroller weiter. Diese Abhängigkeiten auf Papier zu sehen, hat mir mehr gebracht als jede Grafik in der Doku.
Einstieg nach Symptom statt nach System
Frühere Fassungen meiner Dokumentation waren nach Technik sortiert: ein Kapitel für Proxmox, eines für OPNsense, eines für Active Directory. Im Störfall merkst du aber zuerst, dass das Internet weg ist, Windows-Anmeldungen hängen oder Geräte keine IP-Adresse mehr bekommen. Die Notfallseite ordnet jeden Fall nach dem beobachtbaren Symptom und nennt in der mittleren Spalte nur den allerersten Prüfschritt. Alles Weitere bleibt im jeweiligen Runbook, damit die Übersicht auf eine gedruckte Seite passt.
Netzwerk, Gateway und Knoten
Geht das lokale Netz noch, aber das Internet ist weg, prüfst du von einem erreichbaren System aus den Zustand der Firewall-VM:
qm status <id>
# Falls gestoppt:
qm start <id>
Läuft die VM bereits, öffnest du ihre Konsole in der Proxmox-Oberfläche, kontrollierst das WAN-Interface und schaust danach auf Modem und Provider. Antwortet ein ganzer Proxmox-Knoten nicht mehr per SSH, wartest du zunächst einige Minuten ab: Ein eigener Dienst (nic-watchdog) setzt hängende USB-Netzwerkadapter selbstständig zurück. Kommt der Knoten trotzdem nicht wieder, ziehst du den USB-Adapter kurz ab und steckst ihn neu, bevor du den Rechner hart über den Stromschalter neu startest. Anschließend zeigt pvecm status, ob das Cluster-Quorum mit mindestens zwei von drei Stimmen wieder steht.
Namensauflösung, DHCP und Dateiserver
Scheitert die Windows-Anmeldung oder werden interne Namen nicht mehr aufgelöst, liegt der Fehler fast immer bei den Domänencontrollern. Ein ausgefallener AdGuard-Container macht Antworten nur langsamer, legt die Auflösung aber nicht lahm. Für den Betrieb reicht ein einzelner Domänencontroller aus; geprüft wird direkt gegen beide Adressen:
nslookup example.lan 192.0.2.12
nslookup example.lan 192.0.2.13
Verteilen die Server keine IP-Adressen mehr aus dem Pool .200 bis .254, läuft der DHCP-Failover zwischen beiden Domänencontrollern unrund. Auf einem der beiden Windows-Server muss Get-DhcpServerv4Failover den Zustand Normal melden.
Vorsicht ist beim Dateiserver geboten, wenn dort plötzlich Laufwerke fehlen. Die USB-Platten sind direkt an die VM durchgereicht. Hier gilt ein ausdrückliches Neustart-Verbot: Zuerst die Konsole der VM ansehen und auf dem Host mit lsusb prüfen, ob der Host die Gehäuse noch sieht.
Backup, Zertifikate und versperrter SSH-Zugang
Meldet die nächtliche Sicherung einen Fehler oder fehlt ein aktuelles Backup, beginnt die Suche im Aufgabenprotokoll des Backup-Jobs in der Proxmox-Oberfläche. Auf der Kommandozeile zeigt ein schneller Test, ob das Speicherziel überhaupt noch eingebunden ist:
pvesm statusDort muss der Backup-Speicher als aktiv auftauchen. Fehlt er oder bricht der Job ab, geht der nächste Blick in die Weboberfläche des Backup-Servers, um einen vollen Datastore oder eine gestörte Festplatte auszuschließen.
Auch für den eigenen Arbeitsweg ins Cluster gibt es einen festen Rückfallpfad. Normalerweise laufen alle SSH-Verbindungen und Skripte über den zentralen Admin-Container Antwortet dieser Container nicht mehr, wechselst du auf die Konsole seines Hosts und steigst direkt in den Gast ein:
pct enter <id>Bei Zertifikatswarnungen im Browser trennt die Tabelle zwischen zwei Fällen: Ist lediglich das Serverzertifikat eines einzelnen Webdienstes abgelaufen, läuft der Dienst dahinter normal weiter und braucht nur eine Erneuerung. Erst wenn die interne Zertifizierungsstelle selbst betroffen ist, greift das separate Verfahren für den CA-Betrieb. Und wenn ein völlig neues Fehlerbild auftaucht, das in keine Zeile passt, verweist die Notfallseite zuerst auf die Liste der bekannten Fehler mit dokumentierten Umgehungen sowie auf das Änderungslog und die Abweichungsübersicht: Wer hat zuletzt etwas angefasst, und läuft im Lagebild gerade noch eine aktive Wartungssitzung auf dem betroffenen System?
Notstrom über die Wechselrichter
Ein eigener Abschnitt behandelt den Stromausfall. Fällt das öffentliche Netz weg und die Server laufen weiter, versorgen zwei Wechselrichter die Hardware aus den Akkus. Diese Umschaltung ist bereits im Echtbetrieb getestet. Der erste hält den Netzwerkschrank sowie Knoten 1 und Knoten 2; am zweiten hängt Knoten 3. Die Ladestände liest du in Home Assistant ab. Neigt sich die Reserve dem Ende zu, fährst du die Knoten geordnet mit shutdown -h now herunter: zuerst Knoten 3, danach Knoten 1 und ganz zum Schluss Knoten 2, weil dort das Gateway sitzt.
Dieselbe Aufteilung hilft vor einem Firmware-Update an einem der Wechselrichter: Immer nur ein Gerät aktualisieren und vorher die daran angeschlossenen Knoten herunterfahren. Beim ersten fällt dabei vorübergehend auch das Netzwerk weg; dieser Ablauf ist in der Doku bisher als Vorschlag hinterlegt und noch nicht praktisch durchgespielt. War der Strom komplett weg und kehrt zurück, starten die Gäste auf den Knoten automatisch nach ihrer hinterlegten Reihenfolge: zuerst OPNsense, dann die Domänencontroller, AdGuard, Home Assistant und die Verwaltungs-VM, gefolgt vom Backup-Server und dem Dateiserver, danach Medienserver und KI-VM und am Ende die Client-VM. Zehn Minuten nach dem Einschalten kontrollierst du mit pvecm status und einem Blick in die Gästeliste, ob alle Dienste oben sind.
Kennwörter ohne laufenden Tresor
Auf der Notfallseite stehen keine Kennwörter. Im Alltag liegen alle Zugangsdaten in einem selbst betriebenen Passwort-Tresor, und der läuft natürlich auch auf einem der Knoten. Fällt genau dieser aus, brauche ich zum Reparieren trotzdem das Root-Kennwort für die Konsole. Die Notfallseite legt deshalb eine feste Reihenfolge fest, wo ich dann nachsehe.
Zuerst kommen Offline-Kopien, die ohnehin auf meinen Endgeräten liegen, danach ein gedrucktes Notfallblatt und zuletzt ein regelmäßig erzeugter, verschlüsselter Export, der sich in eine frische Installation des Tresors importieren lässt. Wichtig ist, dass jede Stufe ohne die vorherige funktioniert und dass ich die Kette einmal am Stück ausprobiere, nicht nur jede Stufe für sich.
Tägliche Kopie auf einem anderen Knoten
Die Doku selbst läuft auf demselben Knoten wie das Monitoring. Fällt er aus, fehlt sie ganz. Deshalb legt ein Skript jeden Morgen eine vollständige Offline-Kopie auf einem anderen Knoten ab und behält die letzten sieben Tagesstände. Darin liegen vier Teile:
- die druckfertige A4-Fassung mit Notfallseite, Wiederaufbau-Reihenfolge und dem Runbook für den Passwort-Tresor,
- die fertig gebaute statische Website, deren
index.htmlsich nach dem Entpacken ohne Webserver im Browser öffnen lässt, - das ganze Git-Repository als Bundle-Datei, aus der
git clonesofort wieder einen Arbeitsbaum macht, - seit Mitte Oktober auch ein Textexport und ein
pg_dumpder Doku-Datenbank.
Solange der Knoten mit der Kopie im Netz antwortet, hole ich mir die Druckfassung mit einem scp auf den Arbeitsplatzrechner. Ein Prüfskript für die Frische der Doku erinnert alle drei Monate daran, sie neu auszudrucken.
Was noch nicht geübt ist
Auf dem Papier und in den Skripten steht die Kette, in der Praxis sind aber noch drei Punkte offen. Für die Verwaltungs-VM und für Home Assistant läuft zwar alle 30 Minuten eine Replikation auf einen anderen Knoten, das tatsächliche Starten der Verwaltungs-VM aus dieser Replik habe ich bisher nicht durchgespielt. Genauso steht die vierteljährliche Wiederherstellungsprobe der Doku-Datenbank per pg_restore in eine Wegwerf-Datenbank noch aus. Und die neue A4-Druckfassung vom 14. Oktober liegt bisher nur als HTML-Datei in der Kopie: Das Ausdrucken steht noch auf meiner offenen Liste für den Schreibtisch, bevor bis zum 15. November 2026 die erste echte Notfallübung angesetzt ist.
Schreibe einen Kommentar